





在excel里要提取不重复值,随便找个空白单元格输入 =unique(数据区域),按回车后结果会自动往下溢出填充。像品牌、姓名、部门、类别这类经常重复的字段,用unique函数比手动删重复项更适合做动态清单。
UNIQUE是动态数组函数,仅支持Microsoft 365、Excel 2021以及所有带动态数组功能的新版表格软件。旧版Excel找不到这个函数的话,直接用自带的「删除重复项」或者「高级筛选」功能就行;用WPS的朋友记得先确认自己的版本支不支持UNIQUE。
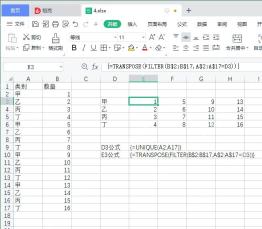
第一步:先确认要去重的是哪一列
打开表格,先定位到你要提取唯一值的字段,比如客户姓名、商品品牌、部门名称、订单类别都可以。如果只提取单列的不重复内容,选数据范围的时候别把表头包进去,不然最终结果里会多出来一行表头文字。
举个例子,原始数据在A2:A17,你打算把生成的不重复值放在D2,就先点中D2。注意D2往下的位置要留空,UNIQUE会自动把所有结果往下批量填充,底下有其他内容的话很容易报错。
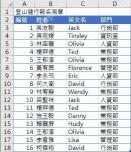
第二步:输入最基础的 UNIQUE 公式
在刚才选中的目标单元格里输入 =UNIQUE(A2:A17),把括号里的A2:A17换成你自己的实际数据范围。按回车之后,Excel会自动把所有不同的值列出来,重复出现再多的内容也只会留一条。
要是你的原始数据已经转成了结构化表格,也可以直接引用表格列,比如写 =UNIQUE(表1[姓名])。这种写法的好处是之后新增数据行的时候,公式会跟着表格的范围自动更新,不用手动改选区。
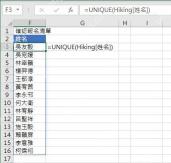
第三步:查看自动溢出的不重复结果
输完公式确认没问题,结果就会从你输公式的单元格开始往下自动展开。之后不管你在原始数据里加行还是删行,UNIQUE生成的不重复列表都会自动同步更新,不用每次重新点删除重复项。
要是输完公式结果没自动展开,先检查目标单元格下面是不是有其他内容占了位置。动态数组函数不能覆盖已有的单元格内容,碰到这种情况把底下的内容清空,或者换个空白位置重新输公式就行。

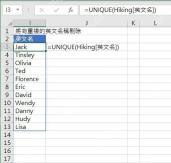
第四步:理解 UNIQUE 的三个参数
UNIQUE的完整语法是 =UNIQUE(array,[by_col],[exactly_once]):第一个参数array就是你要去重的数据区域;第二个参数by_col用来选择按行还是按列比对内容,日常用直接省略或者填FALSE就行;第三个参数exactly_once可以设置要不要只返回「仅出现过一次」的内容。
平时只是提取单列的不重复值,只写第一个参数就完全够用。要是做多列组合去重,直接把整段多列范围放进array就行,比如写 =UNIQUE(A2:B20),它会按整行的内容组合来判断是不是重复项。
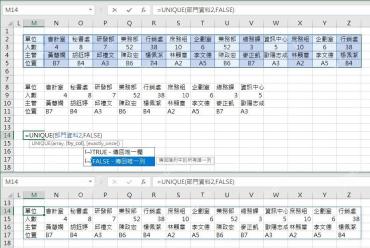
第五步:只提取出现一次的值
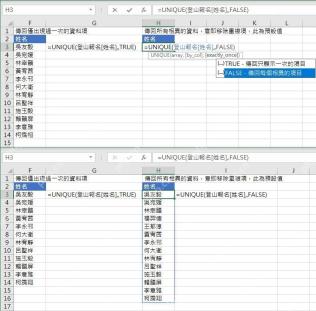
如果你的需求不是生成普通去重清单,而是要找出整张表里只出现过一次的记录,直接把第三个参数设为TRUE就行,比如写 =UNIQUE(A2:A17,,TRUE)。这里第二个参数留空就是默认按行比对,第三个参数设为TRUE之后,最终只会返回原数据里仅出现过一次的内容。
这个用法很适合排查异常订单、统计仅下单一次的客户、找孤立编号这类场景。要注意它和普通去重完全不一样:普通UNIQUE哪怕内容重复多次,也会留一条在结果里;而exactly_once设为TRUE之后,所有出现过不止一次的内容都会被直接排除。
第六步:处理溢出错误和兼容问题
用UNIQUE最常碰到的报错就是 #SPILL!,大多是因为结果要填充的区域被占了、里面有合并单元格,或者公式所在的位置没法正常向下展开。先把目标结果区域清空,取消所有合并单元格,再核对一遍公式就能解决。
还有个常见问题是明明两个单元格内容看起来完全一样,UNIQUE却判定成两个不同的项,大多是内容前后带多余空格、全角半角字符不统一,或者藏了看不见的换行符导致的。可以先用TRIM、CLEAN这类清理函数先把原始数据整理一遍,再用UNIQUE去重就没问题了。
平时做分类清单、下拉菜单数据源、透视分析辅助列的时候,UNIQUE自动同步更新的优势特别明显。只要你的表格版本支持动态数组,优先用这个函数生成清单,比复制完手动删重复项要省心太多,长期维护也更方便。


