






排查 linux auditd 日志过多占用磁盘的问题,核心在于通过 /var/log/audit/ 目录下的文件状态定位异常进程,并调整 /etc/audit/rules.d/audit.rules 中的规则以限制写入频率或过滤无关事件。具体做法是检查当前审计日志的轮转策略和磁盘占用情况,确认是否有特定进程产生了海量审计记录(如频繁的系统调用),然后针对性地修改规则或使用 ausearch 工具进行回溯分析,最终通过优化规则减少不必要的日志输出。

如何快速定位产生大量审计日志的进程
要定位产生大量审计日志的进程,可以使用 ausearch 命令结合时间范围或事件类型进行筛选,或者通过分析 /var/log/audit/audit.log 文件的统计信息来识别高频事件源。通常,某些应用程序(如数据库、Web服务器)可能会因为频繁的读写操作触发大量的 SYSCALL 事件,导致日志迅速膨胀。通过统计不同 exe(可执行文件路径)的出现频率,可以找出“噪音”最大的进程。
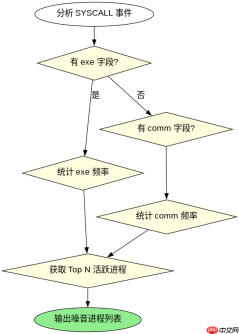
#!/bin/bash
# 脚本名: find_noisy_audit_procs.sh
# 功能: 分析 /var/log/audit/audit.log 中产生最多事件的进程

LOG_FILE="/var/log/audit/audit.log"
TOP_N=10

if [ ! -f "$LOG_FILE" ]; then
    echo "错误: 找不到审计日志文件 $LOG_FILE"
    exit 1
fi

echo "正在分析审计日志,找出前 $TOP_N 个最活跃的进程..."

# 提取 exe 字段,排序并计数,取前 N 个
# 注意: 实际生产中日志可能很大,建议先 gzip 或限制行数测试
grep "type=SYSCALL" "$LOG_FILE" | \
    sed -n 's/.* exe="\([^"]*\)".*/\1/p' | \
    sort | uniq -c | sort -rn | head -n $TOP_N

# 如果没有找到 exe 字段(例如内核事件),则尝试查找 comm 字段
echo "--- 基于 comm 字段的统计 (如果 exe 为空) ---"
grep "type=SYSCALL" "$LOG_FILE" | \
    sed -n 's/.* comm="\([^"]*\)".*/\1/p' | \
    sort | uniq -c | sort -rn | head -n $TOP_N
运行上述脚本后,观察输出结果。如果某个特定进程的 exe 或 comm 出现频率极高,说明该进程是日志占用的主要来源。例如,如果 /usr/sbin/sshd 或 /usr/lib/systemd/systemd 出现在前列,可能需要检查其配置是否开启了过多的调试或审计选项。确定目标进程后,下一步是检查其触发的具体系统调用类型,以便在 audit.rules 中进行优化。
如何通过调整 auditd 规则减少日志量
减少日志量的有效方法是修改 /etc/audit/rules.d/audit.rules 文件,移除对高频低价值事件的监听,或者增加 -k 标签以便后续快速检索,同时确保关键安全事件不被遗漏。常见的优化策略包括:限制对特定系统调用的监控频率(虽然 auditd 本身不支持节流,但可以通过缩小监控范围实现),或者将非关键的 SYSCALL 监控改为仅监控特定用户或组。此外,还可以使用 augenrules 重新加载规则使更改生效。


# /etc/audit/rules.d/audit.rules 示例片段
# 1. 删除过于宽泛的规则,例如移除对所有用户的所有 write 操作监控
# -a always,exit -F arch=b64 -S write -F auid>=1000 -F auid!=unset -k writes

# 2. 保留关键的安全相关规则
# 监控特权命令的执行
-w /usr/bin/sudo -p x -k privilege_escalation
-w /usr/bin/passwd -p x -k password_change

# 3. 针对之前发现的“噪音”进程,如果必须监控,仅监控其关键系统调用
# 假设发现 /usr/bin/my_app 产生大量 read 事件,只监控其 open 和 close
-a always,exit -F arch=b64 -S open,openat -F exe=/usr/bin/my_app -k my_app_file_access

# 4. 设置日志满时的动作,防止磁盘写满导致系统崩溃
-e 2
修改规则后,务必使用 augenrules --load 或 service auditd restart 重新加载规则。为了验证效果,可以再次运行之前的分析脚本,观察新产生的日志中目标进程的事件频率是否下降。需要注意的是,过度精简规则可能会导致安全盲区,因此在调整前应仔细评估每个被移除或修改规则的安全影响。对于确实需要详细记录的进程,可以考虑将其日志重定向到独立的文件或远程日志服务器,以避免本地磁盘压力。
当 auditd 服务因磁盘满而停止工作时如何恢复
当磁盘空间被审计日志耗尽时,auditd 服务通常会停止工作并可能在系统日志中报错,此时首要任务是清理旧日志以恢复磁盘空间,然后重启服务。由于 auditd 在磁盘满时无法写入新日志,直接重启可能无效,因此需要先手动干预。可以通过删除旧的压缩日志文件(如 audit.log-20231001.gz)或使用 truncate 命令清空当前日志文件来释放空间。之后,重新启动 auditd 服务,并检查其状态是否正常。
#!/bin/bash
# 脚本名: recover_auditd.sh
# 功能: 在磁盘满时恢复 auditd 服务

AUDIT_DIR="/var/log/audit"
MIN_FREE_MB=100

# 检查当前磁盘使用情况
FREE_SPACE_KB=$(df -k /var/log/audit | tail -1 | awk '{print $4}')
FREE_SPACE_MB=$((FREE_SPACE_KB / 1024))

echo "当前可用空间: ${FREE_SPACE_MB} MB"

if [ "$FREE_SPACE_MB" -lt "$MIN_FREE_MB" ]; then
    echo "空间不足,开始清理旧日志..."
    # 删除超过7天的旧日志
    find "$AUDIT_DIR" -name "*.gz" -mtime +7 -delete
    # 如果仍然不足,清空当前未压缩的日志(谨慎操作)
    if [ $(df -k /var/log/audit | tail -1 | awk '{print $4}') -lt $((MIN_FREE_MB * 1024)) ]; then
        echo "空间仍不足,清空当前 audit.log..."
        > "$AUDIT_DIR/audit.log"
    fi
else
    echo "空间充足,无需清理。"
fi

# 重启 auditd 服务
echo "重启 auditd 服务..."
systemctl restart auditd

# 检查服务状态
systemctl status auditd --no-pager
执行恢复脚本后,应密切监控磁盘空间和 auditd 的运行状态。为了防止未来再次发生类似问题,建议在 /etc/audit/auditd.conf 中配置更严格的日志轮转策略,例如设置 max_log_file 为较小的值(如 50MB),并启用 num_logs 限制保留的日志文件数量。此外,可以将审计日志发送到远程 syslog 服务器或专用的日志聚合平台,从而减轻本地磁盘的压力。定期审查审计规则也是保持系统健康的重要环节,避免长期积累无用的审计数据。








