






在mysql中,count(*)、count(1)和count(字段)的核心区别在于统计逻辑与优化策略。count(*)统计所有行,包含null值,是官方推荐的标准写法;count(1)在大多数现代引擎中与count(*)等效,因为优化器会将其视为常量行计数;而count(字段)仅统计该字段非null的行。对于大表统计,应避免全表扫描,优先使用覆盖索引或近似算法。
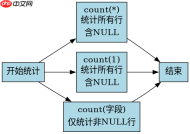
count(*)与count(1)的执行计划差异
在InnoDB引擎中,count(*)和count(1)没有性能差异,优化器会将它们统一转换为对聚簇索引的全表扫描或最小索引扫描。两者都统计所有行,包括含有NULL值的行。区别仅在于语义清晰度,count(*)明确表示“统计行数”,而count(1)在某些旧版本中可能被误解为统计常量1的出现次数,但实际行为一致。
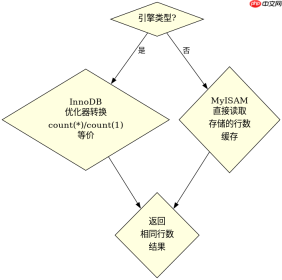
-- 验证 count(*) 与 count(1) 等价性
SELECT COUNT(*), COUNT(1) FROM large_table;
-- 预期结果:两列数值完全相同
count(字段)的NULL处理机制
count(字段)只统计该字段值不为NULL的行。如果字段允许NULL且存在大量NULL值,其结果会小于count(*)。例如,若某列有1000行数据,其中100行为NULL,则count(字段)返回900。这种特性常用于统计有效数据量,但需注意索引使用情况:若该字段有索引,MySQL可能通过索引快速统计非NULL值,避免回表。
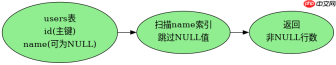
-- 验证 count(字段) 的 NULL 过滤
SELECT COUNT(id), COUNT(name) FROM users;
-- 假设 id 为主键(非NULL),name 可为NULL
-- 预期结果:COUNT(id) = 总行数,COUNT(name) <h2>大表统计的性能瓶颈与替代方案</h2><p>当表数据量超过千万级时,<code>count(*)</code>的全表扫描会导致严重性能问题。此时可采取以下策略:一是使用覆盖索引,如<code>COUNT(primary_key)</code>,利用索引大小远小于表数据的优势加速统计;二是引入近似计数,如使用<code>Bloom Filter</code>或第三方库<code>HyperLogLog</code>,牺牲少量精度换取极高速度;三是缓存统计表,定期异步更新计数值。避免在生产环境直接对超大表执行精确计数查询。</p>


