






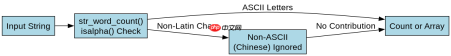
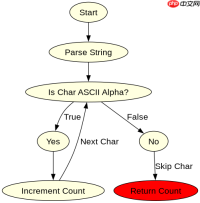
使用 str_word_count() 统计英文单词数时,直接调用该函数即可返回整数结果;中文不准是因为该函数底层依赖 c 语言的 isalpha() 判断字符是否为拉丁字母,遇到非 ascii 字符(如中文)会将其视为分隔符或忽略,导致统计逻辑失效。
str_word_count() 的默认行为与返回值是什么
默认情况下,str_word_count() 只统计由空格、标点符号分隔的连续拉丁字母序列。它返回一个整数,表示找到的单词数量。如果字符串中包含数字或特殊符号,它们通常被视为分隔符,不会计入单词总数,除非使用第二个参数改变返回格式。
$text = "Hello World! This is a test.";
$count = str_word_count($text);
echo $count; // 输出: 6

$text2 = "PHP is great, isn't it?";
$count2 = str_word_count($text2);
echo $count2; // 输出: 5 (PHP, is, great, isn, t)
在第一个例子中,Hello、World、This、is、a、test 被识别为 6 个单词。注意 isn't 中的撇号被视为分隔符,因此 isn 和 t 被算作两个独立的“单词”,这是基于 ASCII 字母连续性的严格定义。开发者需要注意这种边界情况,特别是当输入包含缩写或连字符时。
如何通过第二个参数获取单词列表以辅助调试
将第二个参数设置为 1 可以让函数返回一个数组,包含所有检测到的单词。这对于验证哪些部分被识别为单词非常有用,也能直观地看到非拉丁字符是如何被过滤掉的。通过检查返回数组的内容,可以确认分隔符的位置以及非 ASCII 字符是否导致了意外的分割。

SEO关键词密度优化与页面审计技能。使用场景:①提供页面路径与关键词进行SEO优化;②提升页面关键词密度;③提升搜索引擎排名;④进行SEO审计(meta标签、OG、hreflang等)。触发词:关键词密度、SEO优化、关键词优化等。
$text = "Hello World! PHP 测试";
$words = str_word_count($text, 1);
print_r($words);
/*
Array
(
    [0] => Hello
    [1] => World
    [2] => PHP
)
*/
// 注意:中文“测试”未出现在数组中,且未增加计数
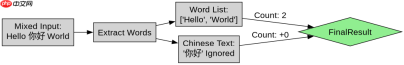
如上所示,str_word_count 仅提取了 Hello、World 和 PHP。中文文本 测试 完全被忽略,既没有出现在数组中,也没有贡献任何计数。这是因为 isalpha() 对 UTF-8 编码的中文字符返回 false,视其为空白或非字母字符。若需统计中文,应改用正则表达式 /[\x{4e00}-\x{9fa5}]+/u 进行匹配。
为什么中文输入会导致统计结果为 0 或偏少
当输入纯中文或中英文混合且无空格分隔拉丁词时,str_word_count() 可能返回 0 或仅统计其中的英文部分。这是因为函数无法识别中文字符作为单词的一部分,也无法将其作为有效的分隔符来界定拉丁单词的边界(除非有显式空格)。对于纯中文句子,由于没有任何 ASCII 字母序列,结果恒为 0。
$chinese_only = "你好世界";
echo str_word_count($chinese_only); // 输出: 0

$mixed = "Hello 你好 World";
echo str_word_count($mixed); // 输出: 2 (Hello, World)

$mixed_no_space = "Hello你好World";
echo str_word_count($mixed_no_space); // 输出: 2 (Hello, World)
// 中文夹在中间,但因为没有空格,且中文不被视为字母,
// 所以 Hello 和 World 仍被正确识别为两个独立单词
在 Hello你好World 的例子中,尽管没有空格,str_word_count 依然能识别出 Hello 和 World,因为中文字符起到了类似分隔符的作用(即非字母字符)。然而,如果目标是统计“词”的概念,这种基于字节和 ASCII 的判断方式显然不符合自然语言处理的需求。对于中文场景,必须放弃此函数,转而使用支持 Unicode 的正则表达式或专门的 NLP 库。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


