






使用 `ltrim()` 函数并指定 utf-8 bom 字符作为过滤参数即可去掉字符串开头的 bom 头。`` 是 utf-8 编码下 bom(byte order mark)的可见显示形式,它由三个字节 `0xef 0xbb 0xbf` 组成,用于标识文本文件采用 utf-8 编码,但在纯文本处理中通常被视为无效字符需要移除。
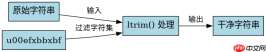
ltrim() 去除 BOM 的具体实现
直接调用 ltrim($string, "\xEF\xBB\xBF") 是最标准的做法。该函数会从字符串左侧开始移除所有出现在第二个参数中的字符,由于 BOM 仅出现在文件开头,因此只需处理起始位置。如果输入字符串不包含 BOM,函数将原样返回字符串,不会引发错误或截断正常内容。
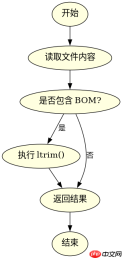
$content = file_get_contents('example.txt');
$clean_content = ltrim($content, "\xEF\xBB\xBF");
echo bin2hex($clean_content); // 输出清理后的十六进制内容
上述代码首先读取文件内容,然后应用 ltrim 移除潜在的 BOM。执行后,$clean_content 将是一个干净的 UTF-8 字符串,适合后续拼接或数据库写入操作。若文件本身无 BOM,$clean_content 与原始内容完全一致。
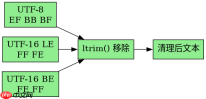
不同编码下的 BOM 差异对比
UTF-8 BOM 对应字节序列为 EF BB BF,而 UTF-16 LE 和 BE 分别对应 FF FE 和 FE FF。在处理未知编码文件时,需先检测编码再选择对应的 BOM 移除策略。例如,UTF-16 LE 的 BOM 在 PHP 中应表示为 "\xFF\xFE"。若错误地使用 UTF-8 的 BOM 去清理 UTF-16 文件,将无法移除其头部标记,导致解析失败。

$utf16le_bom = "\xFF\xFE";
$utf16be_bom = "\xFE\xFF";
$utf8_bom = "\xEF\xBB\xBF";

// 假设已知文件为 UTF-16 LE
$content = file_get_contents('utf16_file.txt');
$clean_utf16 = ltrim($content, $utf16le_bom);

// 假设已知文件为 UTF-8
$clean_utf8 = ltrim($content, $utf8_bom);
通过定义不同编码的 BOM 常量,可以针对性地清理相应文件。在实际应用中,建议结合 mb_detect_encoding() 或第三方库自动识别编码,再调用对应的 ltrim 逻辑。这种分步处理方式能确保多语言环境下的文本兼容性,避免因编码误判导致的乱码问题。
空字符串或纯 BOM 输入的边界情况
当输入字符串为空或仅包含 BOM 字符时,ltrim() 会返回空字符串。例如,若文件仅含 BOM 而无实际内容,清理后结果为 ""。这种行为符合预期,因为 BOM 被视为可移除字符,移除后无剩余内容。开发者需注意,若业务逻辑依赖非空校验,需在清理后额外检查字符串长度,防止因意外清空导致后续逻辑异常。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


