






深分页慢是因为数据库需要扫描并丢弃大量无用数据,游标分页通过记录上次查询的边界值(如id)来跳过这些数据。具体做法是放弃使用`limit offset, count`,改为在where条件中指定`id > last_id`并限制返回数量。这样数据库只需从指定位置开始扫描所需行数,避免了全表扫描和内存排序。

为什么LIMIT 100000,20会非常慢
当执行类似`SELECT * FROM table LIMIT 100000, 20`时,数据库引擎必须先读取前100,020行数据,然后在内存中丢弃前100,000行,最后才返回剩下的20行。随着偏移量offset增大,这种性能损耗呈线性增长,因为无论是否使用索引,MySQL都需要回表查询或扫描索引树来定位这些被丢弃的行。
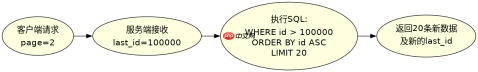
SELECT id, name FROM users WHERE id > 100000 ORDER BY id ASC LIMIT 20;
上述查询利用主键索引,直接从第100,001个位置开始扫描,只读取20行数据,效率极高。注意:这种方法要求字段具有唯一性且有序,通常使用自增主键。如果业务场景允许ID不连续,这是最佳实践。
游标分页的具体实现逻辑
游标分页的核心在于“基于上一次的结束位置继续查找”。客户端第一次请求时获取前N条数据及最后一条数据的ID;后续请求时,将该ID作为参数传给服务端,服务端构造`WHERE id > last_id`的条件进行查询。这种方式保证了每次查询的数据量固定,且无需计算总页数,适合无限滚动加载的场景。
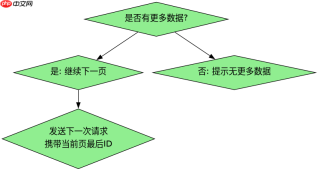
SELECT id, name FROM users WHERE id > :last_cursor ORDER BY id ASC LIMIT 20;
在实际开发中,需确保`last_cursor`来自上一次查询结果的末尾记录。若存在并发插入导致ID跳跃的情况,建议结合时间戳或其他唯一复合键进行排序,以避免数据遗漏或重复。对于非主键字段的排序,可建立联合索引以加速范围查询。
如何处理非主键字段的深分页问题
当无法使用主键ID作为游标时,可以使用覆盖索引优化。例如按创建时间排序,先查询出符合条件的最小ID,再基于该ID进行范围查询。或者使用延迟关联(Deferred Join),先通过覆盖索引查出ID列表,再回表查询完整数据。这两种方法都能显著减少回表次数,提升深分页性能。


