






php中`substr`按字节截取,emoji是多字节字符,截断会破坏utf-8编码导致乱码。使用`mb_substr`并指定`utf-8`编码可正确按字符截取。
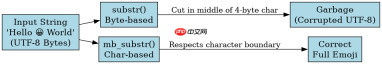
为什么substr会截断Emoji?
`substr`函数基于字节长度进行截取,而Emoji在UTF-8编码下通常占用4个字节。当截取位置落在Emoji的中间字节时,会产生无效的UTF-8序列,从而显示为乱码。
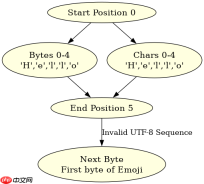
$str = "Hello ? World"; // Hello [Face] World
$bad = substr($str, 0, 5); // "Hello" (OK)
$bad2 = substr($str, 0, 6); // "Hello + first byte of Emoji" -> Garbage
预期结果:`$bad`为"Hello",`$bad2`包含乱码字符。
mb_substr如何正确截取?
`mb_substr`基于字符计数而非字节计数,能识别多字节字符边界,确保Emoji完整保留。需显式指定`UTF-8`编码以兼容不同环境。

$str = "Hello ? World";
$good = mb_substr($str, 0, 6, 'UTF-8'); // "Hello " (includes full Emoji)
echo $good; // Output: Hello [Face]
预期结果:`$good`为"Hello [Face]",无乱码。
mb_substr处理空字符串或越界输入的结果是什么?
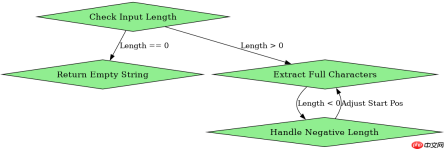
当输入为空字符串时,`mb_substr`返回空字符串;当起始位置超出字符串长度时,返回空字符串;当长度参数为负数时,从末尾截取相应长度。这些行为与`substr`类似,但始终保证字符完整性。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


