






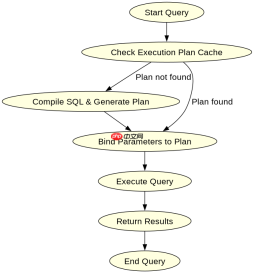
预处理语句能显著提升重复查询性能,其核心原理是将 sql 模板与数据分离,由数据库先编译执行计划,后续仅传输参数。在 node.js 中,使用 `mysql2` 库的 `pool.execute()` 或连接对象的 `execute()` 方法即可实现服务端预处理。这避免了每次查询都进行 sql 解析、语法检查和优化器生成执行计划的开销,同时天然防止 sql 注入。

Node.js 中如何调用预处理语句
在 Node.js 环境下,通过 `mysql2` 库可以方便地使用预处理语句。关键在于使用占位符(如 `?`)代替具体的值,并传入参数数组。数据库服务器会缓存这个带有占位符的 SQL 语句的执行计划。当再次执行相同的 SQL 模板但参数不同时,客户端只需发送新的参数值,服务器端直接复用之前的执行计划,从而减少网络往返和 CPU 计算量。
// 引入 mysql2 模块
const mysql = require('mysql2/promise');

// 创建连接池
const pool = mysql.createPool({
  host: 'localhost',
  user: 'root',
  password: 'password',
  database: 'test_db'
});

async function runPreparedQuery() {
  const connection = await pool.getConnection();
  try {
    // 定义带占位符的 SQL 模板
    const sql = 'SELECT * FROM users WHERE id = ? AND status = ?';

    // 第一次执行:服务器解析 SQL 并生成执行计划
    const [rows1] = await connection.execute(sql, [101, 'active']);
    console.log('First query result:', rows1);

    // 第二次执行:复用执行计划,仅传输参数
    const [rows2] = await connection.execute(sql, [102, 'inactive']);
    console.log('Second query result:', rows2);
  } finally {
    connection.release();
  }
}

runPreparedQuery();
上述代码展示了标准的预处理流程。首先建立连接池,然后在查询中使用 `?` 作为占位符。调用 `execute` 方法时,第二个参数是包含实际值的数组。服务器端接收到第一次请求后,会将 `SELECT * FROM users WHERE id = ? AND status = ?` 编译成内部执行计划。后续相同模板的查询将跳过编译阶段,直接绑定新参数并执行。这种机制在处理高频重复结构的查询时效果尤为明显。
预处理语句在不同数据库中的行为差异
虽然预处理语句的原理通用,但在不同数据库系统中,其具体行为和限制有所不同。例如,MySQL 支持服务端预处理,而 SQLite 默认使用客户端预处理(即拼接 SQL 字符串)。PostgreSQL 也支持服务端预处理,但通常通过协议层面的 `Parse` 和 `Bind` 命令实现。理解这些差异有助于在跨数据库项目中正确选择实现方式。此外,某些数据库对预处理语句的数量有限制,或者在特定条件下(如动态表名)无法使用预处理。

-- MySQL 示例:使用 PREPARE 语句
PREPARE stmt FROM 'SELECT * FROM users WHERE id = ?';
SET @id = 101;
EXECUTE stmt USING @id;
DEALLOCATE PREPARE stmt;

-- PostgreSQL 示例:使用 DO 块和 PREPARE
PREPARE stmt(int) AS SELECT * FROM users WHERE id = $1;
EXECUTE stmt(101);
DEALLOCATE stmt;
以上代码展示了 MySQL 和 PostgreSQL 中手动管理预处理语句的方式。在 MySQL 中,需要先 `PREPARE` 一个语句,然后 `EXECUTE` 它,最后 `DEALLOCATE` 释放资源。在 PostgreSQL 中,语法类似,但参数引用使用 `$1`, `$2` 等。需要注意的是,手动管理预处理语句通常用于存储过程或脚本中,而在应用层(如 Node.js)中,驱动库会自动处理这些细节。开发者应优先使用驱动库提供的高级 API,而不是手动发送底层协议命令。
预处理语句在参数类型转换时的潜在问题
在使用预处理语句时,如果参数类型与数据库列类型不匹配,可能会引发隐式类型转换,导致索引失效或查询结果不符合预期。例如,将字符串 `'101'` 传递给整数类型的 `id` 列,虽然大多数数据库能正确处理,但可能无法使用 `id` 列上的索引。此外,某些数据库在处理特殊字符或空值时,预处理语句的行为可能与直接拼接 SQL 不同。因此,确保参数类型与列类型一致是优化预处理查询的关键。
const mysql = require('mysql2/promise');
const pool = mysql.createPool({
  host: 'localhost',
  user: 'root',
  password: 'password',
  database: 'test_db'
});

async function testTypeConversion() {
  const connection = await pool.getConnection();
  try {
    // 假设 id 列是 INT 类型
    const sql = 'SELECT * FROM users WHERE id = ?';

    // 传入字符串而非整数
    const [rows] = await connection.execute(sql, ['101']);
    console.log('Result with string param:', rows);

    // 检查是否使用了索引
    const explain = await connection.execute('EXPLAIN SELECT * FROM users WHERE id = ?', ['101']);
    console.log('Explain plan:', explain[0]);
  } finally {
    connection.release();
  }
}

testTypeConversion();
这段代码演示了类型转换的问题。当传入字符串 `'101'` 时,数据库可能会将其转换为整数进行比较。虽然结果正确,但可能无法利用索引。通过 `EXPLAIN` 语句可以查看执行计划,确认是否使用了索引。最佳实践是始终传递与列类型匹配的参数,例如使用 `parseInt()` 或 `Number()` 转换输入值。这样可以确保查询性能最优,并避免潜在的兼容性问题。






