excel从文本里提数字,先看文本结构:位置固定就用mid,分隔符稳定可以搭配textafter和textbefore,提取完再决定留文本格式还是转数值。这里只处理编号里两个短横线中间的数字段,没法清理任意混杂文本。前导零属于编号的一部分必须留,要参与计算才用value;先检查分隔符、长度和异常记录,再整列填充,别把负号、小数点或其他编号拼成错数字。
固定位置用 MID,先保留编号前导零
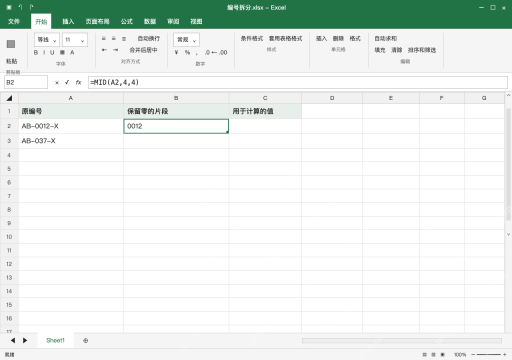
A2 为 AB-0012-X,B2 输入 =MID(A2,4,4),得到文本 0012。语法 MID(text,start_num,num_chars) 从第 4 个字符取 4 位,位置从 1 计数;它不会判断这段是否都是数字,只有当前长度规则一致时才能直接整列填充。
长度不固定时,按两个分隔符取中间段
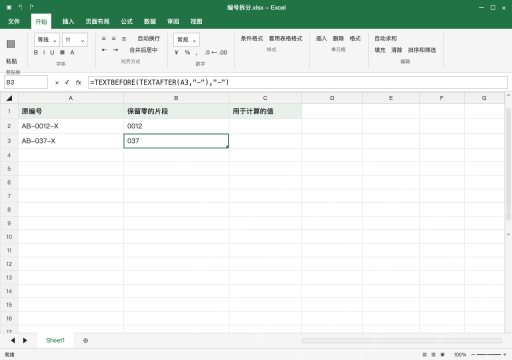
支持 TEXTAFTER、TEXTBEFORE 的 Microsoft 365 或 Excel 2024,在 B2 输入 =TEXTBEFORE(TEXTAFTER(A2,"-"),"-"),向下填充。B2 为 0012、B3 为 037,第二条不再按固定四位截取;旧版没有函数时可用分列或按明确规则另写公式,不能把 #NAME? 当数据本身出错。
要做计算再用 VALUE,不覆盖编号文本
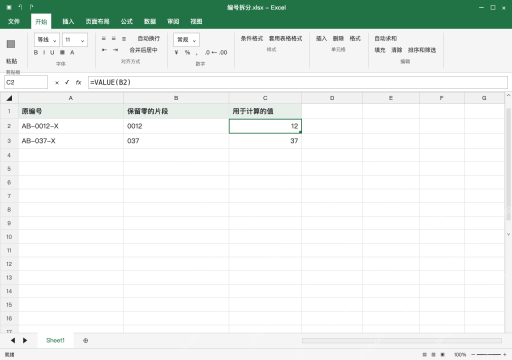
C2 输入 =VALUE(B2),得到数值 12;填到 C3 得 37。B 列仍保留 0012、037,C 列用于计算,二者含义不同;身份证、电话或长编号不要为了提取方便一律转数值,超过精度限制的尾数不能靠格式补回。

解析 MySQL 8.0 的 DDL 脚本,并将表结构导出为 Excel 格式。适用于用户需将 MySQL 的 `CREATE TABLE` 语句转换为结构化的 Excel 文件场景,导出内容包含字段名、数据类型、长度及精度等信息。支持多张表的批量处理,每张表对应 Excel 中的一个独立工作表。适用于数据库文档编写、数据字典生成及模式分析等任务。
先标出缺分隔符的异常,再保存结果
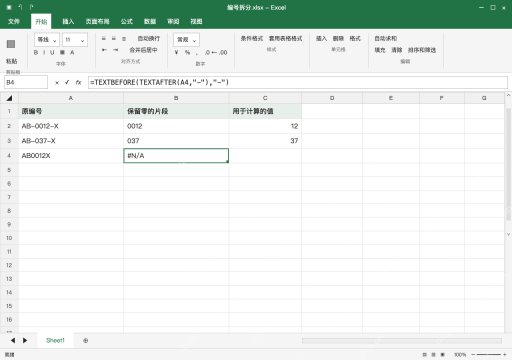
A4 若是 AB0012X,按双分隔符公式会报 #N/A,先保留错误用于核查,不把异常默默替换成零。确认编号结构后修正来源,重新提取并抽查首尾记录;同一格有多个数字片段时先约定取哪一段,不能把所有数字粘一起当成原值。