





月之暗面最新发布的 Kimi K3 大模型表现亮眼,也很快带动市场围绕“是否会复刻 DeepSeek 时刻”的讨论升温。一部分资金曾担心,美股 AI 板块会不会再次出现明显抛压。不过,多家华尔街机构随后给出的判断却比较一致,而且结论有些“反直觉”:Kimi K3 的突破并没有削弱高端算力需求,反而可能进一步强化这一趋势。
如果用更容易理解的话来说,逻辑并不复杂。大模型想要变强,前期训练通常离不开大规模 GPU 集群;而当模型推理效率提升、能力也更强时,它往往更容易被企业和开发者真正用起来。一旦部署范围扩大、调用频次增加,对 GPU、存储、网络和数据中心的需求也可能随之上升。也正因为如此,市场对 AI 产业链的关注点,正在从单纯讨论“能不能降本”,逐步转向“会不会带来更大的需求扩张”。
换句话说,市场虽然一度把 Kimi K3 当作“DeepSeek 时刻 2.0”来看待,但这一次,华尔街主流机构的结论并不相同。
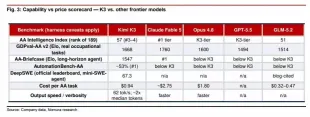
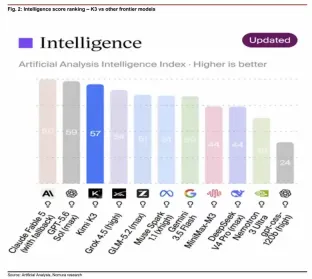
7 月 16 日深夜,月之暗面在上海发布 Kimi K3。这个 2.8 万亿参数的开源模型,在 Artificial Analysis 智能指数中获得 57 分,排名全球第三至第四位,与 Anthropic 的 Claude Opus 4.8 和 OpenAI 的 GPT-5.5 处于同一区间。更受关注的是,在加州大学伯克利分校创建的 Frontend Code Arena 编程榜单中,K3 以 1679 分登顶,超过 Claude Fable 5 和 GPT-5.6 Sol,成为首个在权威编程榜单上超越全部海外闭源模型的开源模型。
7 月 17 日,美股半导体板块出现明显回调。这样的市场反应并不难理解。因为在 2025 年初 DeepSeek R1 发布后,算力股就曾经历过一轮快速下跌。当时市场最核心的担忧是:如果中国模型持续逼近全球前沿水平,美国 AI 公司是否还需要维持如此高强度的算力投入?如果更低成本模型不断出现,英伟达、HBM、服务器和网络设备的需求预期是否要被重新定价?
不过,据追风交易台消息,瑞银、野村、美银美林和花旗等多家机构的最新观点认为:Kimi K3 不是算力需求的终结者,更像是新一轮算力需求扩散的催化剂。
从市场影响来看,Kimi K3 与 DeepSeek R1 带来的冲击并不完全一样。R1 更强调效率,而 K3 更突出规模。2.8 万亿参数、1M token 上下文、常开推理、原生多模态以及 MoE 架构,这些特征共同决定了它并不属于“轻资产”叙事。相反,它会同时抬升推理、内存、网络和存储侧的基础设施压力。
Kimi K3 是什么:先看懂它的能力、定位和成本
Kimi K3 由月之暗面于 2026 年 7 月 16 日发布,完整模型权重计划于 7 月 27 日开放。作为一款 2.8 万亿参数的开源权重大模型,它被多家机构视为当前规模最大的开源权重 LLM 之一。
如果从新手更容易理解的角度来看,K3 主要有三项值得关注的特征:
- 1M token 上下文窗口:简单理解,就是它一次能处理的信息量更大,适合长文本阅读、复杂代码仓库分析,以及更大体量的企业资料处理。
- 常开推理能力:这说明它不只是做简单问答,更偏向处理多步骤、长链路的问题,也更适合 Agent 类任务。
- 原生视觉能力:除了文本,它还可以覆盖图像、视频、游戏开发、前端设计、CAD 等多模态场景。
在架构层面,K3 采用 Kimi Delta Attention、Attention Residuals 和 Stable LatentMoE。MoE 部分由 896 个专家构成,每个 token 激活其中 16 个专家。月之暗面的说法是,与 Kimi K2 相比,整体 scaling efficiency 提升约 2.5 倍。
这也解释了为什么 K3 不能被简单理解成“更便宜的 K2”。根据 Nomura 整理的数据,K3 输入价格为每百万 token 3 美元,缓存命中输入为 0.30 美元,输出价格为每百万 token 15 美元;按 Artificial Analysis 的口径,K3 每项任务成本约为 0.94 美元,低于 Claude Fable 5 的约 2.75 美元和 Claude Opus 4.8 的约 1.80 美元,接近 GPT-5.6 Sol 的 1.04 美元。不过,它仍明显高于 GLM-5.2 的 0.32—0.47 美元,也远高于 DeepSeek V4 Pro 的 0.04 美元。
因此,如果从币圈、Web3 和 AI 产业观察的视角来看,Kimi K3 的定位并不是“最低价模型”,而是在一个更有竞争力的价格区间里,尽量接近前沿模型的能力水平。
Kimi K3 会削弱算力需求吗:四家投行怎么看
围绕“Kimi K3 会不会重演 DeepSeek 冲击”这个问题,多家投行的结论基本一致:这更像是需求重估,而不是需求削弱。
野村:AI 竞争加剧,基础设施价值链反而可能受益
野村证券亚太科技团队分析师段冰在报告中表示,全球大模型市场的竞争与创新不会停止。随着行业继续向通用人工智能靠近,生成式 AI 在消费端和企业端的应用仍会扩张。前沿 AI 实验室和超大规模云平台公司,大概率仍会维持高投入,以确保自身竞争位置。在这个框架下,野村把竞争升级视为 AI 基础设施价值链的正面信号。
花旗:这更像是“杰文斯悖论”再次出现
花旗半导体分析师 Peter Lee 在 7 月 19 日的报告中,直接将这一主题概括为“又一次杰文斯悖论”。这个概念可以简单理解为:当技术效率提高、使用门槛下降时,结果不一定是总需求减少,反而可能因为更多人愿意使用,带来更大的整体消耗。
放到 AI 行业里,如果高质量模型变得更便宜、更容易部署,开发者和企业就可能上线更多应用、处理更多 token,最终推高整体算力消耗。
Peter Lee 还指出,即便 K3 获得更广泛应用,服务器 DDR5 和 eSSD 等通用内存与存储需求仍有继续增长的空间。原因在于,K3 的推理效率虽然接近其他前沿模型,但随着上下文长度增加,KV 缓存占用也会持续放大,内存压力不会因为效率提升而自动下降。
美银美林:美国前沿实验室可能会选择“更多算力”
美银证券半导体分析师 Vivek Arya 在 7 月 17 日的报告中给出的表述更直接:美国前沿 AI 实验室的回应不会是“更少算力”,而是“更多算力”。如果中国开源模型持续逼近,OpenAI、Anthropic 和 Google 为了维持差异化,可能需要投入更大规模训练、更重推理以及更快的产品迭代。
Arya 还提到,媒体报道称 Google 的 Gemini 3.5 Pro 已较原计划推迟数月,且编程能力未达到内部目标。这也从一个侧面说明,前沿模型想长期保持领先,难度正在上升。
瑞银:K3 更偏“规模”逻辑,长上下文会继续推高内存压力
瑞银分析师 Timo Arcuri 团队在 7 月 20 日的报告中指出,K3 与 DeepSeek R1 的确存在可比性,但 K3 的重点更偏向“规模”。它拥有 2.8 万亿参数和 100 万 token 上下文窗口。报告强调,开源模型通常比闭源前沿模型更吃内存,尤其在更长上下文场景下,即便进行量化处理,KV 缓存的绝对需求仍会增长,这使得开源模型部署对 HBM 和存储的依赖度更高。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
Kimi K3 可能影响哪些方向:算力、存储、网络、云平台怎么理解
从机构观点来看,Kimi K3 对产业链的影响并不是平均分布的,而是更可能集中在几个关键环节。对于不熟悉 AI 基建的新手来说,可以把它理解为:模型越强、应用越多,背后承载这些能力的“底层硬件和服务”就越重要。
1. 存储与内存:HBM、DDR5、eSSD 关注度提升
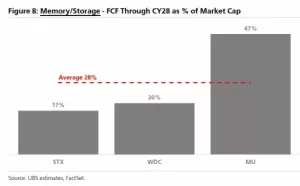
存储与内存是机构普遍认为最直接受益的板块之一。瑞银测算显示,到 2028 年,存储与内存板块累计自由现金流预计可达到市值的约 30%,在各子板块中占比最高,其中美光(MU)约为 47%。花旗和野村也维持对三星电子的买入评级,原因之一是全球内存市场仍处于供给偏紧状态。
花旗指出,Kimi K3 在推理侧的内存需求并不弱于其他前沿模型,KV 缓存规模上升将直接带动服务器 DDR5 与企业级固态硬盘需求。其特别提到,K3 大规模部署需要超过 64 块 GPU 的“超节点”集群配置。
2. 算力基础设施:英伟达、台积电等仍是关键变量
算力基础设施方面,台积电与英伟达被视为重点受益方向。无论是训练侧的规模定律继续发挥作用,还是推理侧 token 使用量持续增长,最终都对应更多先进制程芯片需求。野村重申对台积电、ASE、联发科等公司的买入评级。
英伟达此前公开表示,现代 MoE 模型在 GB300 NVL72 上的推理性能功耗比,相较上一代 Hopper 架构可提升高达 25 倍。像 K3 这样的模型,也被认为天然更能受益于英伟达最新硬件平台。
3. 网络侧:超节点架构会抬高光模块与光芯片需求
网络侧也被视为结构性机会所在。原因在于,Kimi K3 需要超节点集群,而中国本土算力又受到高端芯片出口限制影响,超节点架构被认为是弥补单卡性能差距的重要方案之一。这会进一步推升光模块、光芯片等网络层供应链需求。野村看好中际旭创和苏州旭创。
4. 云平台与数据中心:模型分发和企业部署价值上升
云平台与数据中心同样被机构重点提及。能够托管多种前沿开源模型的云平台,通常具备更强议价能力,也不必过度依赖单一闭源模型供应商。野村看好阿里巴巴(BABA)在中国 AI 云生态中的核心位置,同时关注 GDS、万国数据(VNET)等数据中心运营商。
中国 AI 模型全球渗透率变化:开发者流量是个重要信号
在这轮讨论中,一个容易被忽视但实际上很关键的变量,是中国 AI 模型在全球开发者生态中的渗透速度。
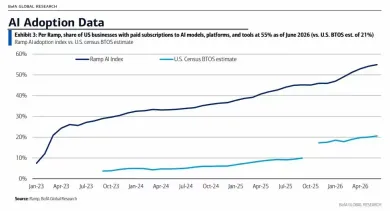
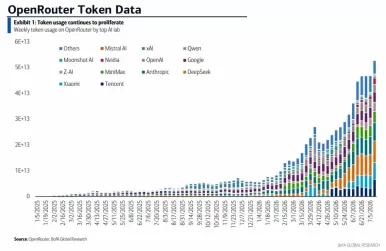
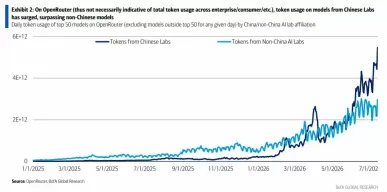
根据开放 API 网关 OpenRouter 的统计,中国 AI 模型在全球开发者流量中的 token 使用占比,一年前不足 2%,目前已超过 45%。与此同时,美银美林的数据也显示,AI 整体渗透正在加快:目前约 55% 的美国企业已订阅 AI 模型、平台或工具,Anthropic 的企业采用率为 42%,OpenAI 为 40%。在头部 AI 消费者中,前 1% 的企业用户每位员工每月 AI 支出已达到 4833 美元。
从竞争格局来看,市场正在出现更明显的分层。一边是以 DeepSeek、Kimi K3 为代表的中国开源模型,覆盖经济型及中高端性价比市场;另一边是美国顶级前沿模型,继续向更复杂的工作负载,例如科学计算等场景集中,以维持技术溢价和定价能力。野村的判断是,中美两侧的领先大模型玩家都可能受益,前提是能够持续处于技术曲线前沿。
Kimi K3 改变了什么:它更像是在重塑 AI 竞争节奏
K3 发布后,市场第一时间仍会把它与 DeepSeek R1 放在一起比较。这种比较本身并没有问题,但如果讨论只停留在“会不会再次打击 AI 硬件”这个层面,显然还不够全面。
如果说 DeepSeek 让市场重新评估了训练效率,那么 Kimi K3 进一步证明的是:开源模型同样能够在规模、长上下文、Agent 和多模态等方向推进到前沿区间。
这意味着,美国前沿实验室可能仍需保持高投入,而中国模型也有望在全球开发者生态中继续扩大影响力。闭源顶级模型保留技术和价格溢价,开源模型则覆盖更广的价格带与部署场景;云厂商承担模型分发和企业落地,硬件产业链继续承接训练与推理侧的基础设施压力。
短期来看,受“DeepSeek 记忆”影响,相关交易仍可能出现波动。中期来看,只要 token 使用量继续增长,长上下文和 Agent 场景持续扩散,算力、HBM、存储、网络和 IDC 仍会是难以绕开的关键成本项。
这也是为什么多家机构在 K3 发布后给出了相似结论:更强的开源模型,并不是 AI 基建需求的终点,反而可能成为下一轮需求扩散的起点。
不过,美银美林也明确提示了一项尾部风险:如果效率提升的速度快于工作负载增长,那么基础设施建设节奏可能出现回落。换句话说,如果模型持续变得更便宜,但使用量未能同步明显扩张,算力需求增长逻辑也会受到影响。后续仍需要结合模型部署进度、企业采纳情况以及实际 token 消耗变化持续观察。
需要说明的是,以上内容主要围绕机构观点和产业逻辑展开,属于行业信息解读,并不构成任何投资建议。AI、半导体、算力及相关概念资产波动通常较大,市场判断也可能随技术进展和企业实际落地情况而变化。



