






Linux 文件编码怎么转换避免乱码
使用 iconv 命令配合正确的源编码和目标编码参数进行转换,例如将 gbk 编码的文本转换为 utf-8 编码。执行 iconv -f gbk -t utf-8 input.txt -o output.txt 即可生成无乱码的新文件。若不确定原文件编码,可先用 file 命令查看,或使用 recode 工具尝试自动检测。转换后务必检查新文件内容是否显示正常。
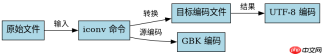
如何确定文件的原始编码格式
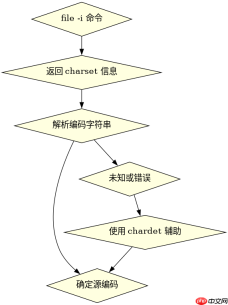
使用 file 命令可以查看文件的 MIME 类型和字符集描述,从而判断其原始编码。对于纯文本文件,file -i filename 会直接输出包含 charset 的信息。如果 file 无法准确识别,可以使用 chardet 或 icu 提供的工具进行概率分析。确认编码是正确转换的前提,否则可能导致转换失败或产生新的乱码。

#!/bin/bash
# 检查文件编码并转换示例
INPUT_FILE="test.txt"
TARGET_ENCODING="UTF-8"

# 获取当前编码
CURRENT_ENCODING=$(file -i "$INPUT_FILE" | grep -oP 'charset=\K[^;]+')
echo "Detected encoding: $CURRENT_ENCODING"

# 如果检测到的是 GBK,则转换为 UTF-8
if [ "$CURRENT_ENCODING" = "iso-8859-1" ] || [ "$CURRENT_ENCODING" = "us-ascii" ]; then
    # 假设它是 GBK (file 有时对 GBK 识别不准,需人工确认)
    echo "Assuming GBK based on context, converting..."
    iconv -f GBK -t UTF-8 "$INPUT_FILE" > "${INPUT_FILE%.txt}_utf8.txt"
else
    iconv -f "$CURRENT_ENCODING" -t "$TARGET_ENCODING" "$INPUT_FILE" > "${INPUT_FILE%.txt}_${TARGET_ENCODING,,}.txt"
fi

# 验证结果
file -i "${INPUT_FILE%.txt}_${TARGET_ENCODING,,}.txt"
转换后如何验证文件内容是否正常
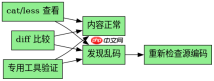
转换完成后,使用 cat 或 less 查看文件内容,确保中文或其他非 ASCII 字符显示正确。可以使用 diff 比较转换前后的文件差异,注意忽略编码导致的字节差异,重点关注语义一致性。对于二进制文件或特殊格式文件,应使用专用工具打开验证。若发现乱码,需重新检查源编码设置是否正确。
# 验证转换后的文件
NEW_FILE="test_utf8.txt"

# 查看文件信息
file -i "$NEW_FILE"

# 查看内容(确保终端支持 UTF-8)
cat "$NEW_FILE"

# 与原始文件对比(仅适用于文本内容一致的情况)
diff





