






php调用ollama处理超长输入时,核心策略是截断文本以符合模型上下文窗口限制。具体做法是在发送请求前,使用`mb_substr()`或`substr()`函数将长文本截取为最大允许长度(如4096个字符),并保留末尾的结束标记(如``)。这样做能确保api调用不报错,同时尽量保留关键信息。
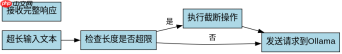
如何确定Ollama模型的上下文窗口大小?
不同模型支持的上下文长度不同,通常通过查询模型元数据或查阅官方文档获取。例如,Llama 3通常支持8k或更长,而较小的模型可能仅支持2k。在代码中,我们应硬编码一个安全值,或者动态获取后做减法预留系统提示词空间。
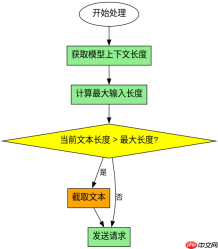
$model = 'llama3';
$context_length = 8192; // 假设模型支持8k
$system_prompt = "You are a helpful assistant.";
$max_input_len = $context_length - strlen($system_prompt) - 100; // 预留token空间
if (strlen($text) > $max_input_len) {
    $text = mb_substr($text, 0, $max_input_len, 'UTF-8');
}
截断时应该保留文本的前半部分还是后半部分?
这取决于业务场景。对于摘要生成,通常保留开头;对于对话历史,通常保留最近的消息(即尾部)。在PHP实现中,我们可以提供一个参数来控制截断方向。默认情况下,为了保持语义连贯性,建议保留头部,除非明确知道尾部包含最新指令。

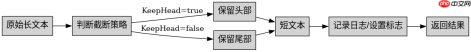
function truncateText($text, $maxLength, $keepHead = true) {
    if (mb_strlen($text, 'UTF-8') <h2>如果输入被截断,如何告知用户或记录日志?</h2><p>当输入因超长而被截断时,程序应返回一个标志位或在响应头中包含警告信息。在PHP中,可以在返回的JSON结构中增加一个`truncated`字段,值为布尔型。同时,建议在服务器日志中记录原始长度和截断后的长度,以便后续分析哪些输入经常触发截断,从而优化前端交互或后端逻辑。</p>
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





