






php无法直接调用claude api分析pdf,因为api仅接受文本输入。必须先在本地使用库提取pdf中的文字,再将提取的文本作为参数发送给claude。

如何提取PDF中的纯文本
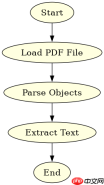
使用`smalot/pdfparser`库可以读取PDF文件并获取其中的文本内容。该库将PDF解析为对象数组,通过遍历这些对象可以拼接出完整的字符串。
$composer require smalot/pdfparser
$parser = new \Smalot\PdfParser\Parser();
$pdf = $parser->parseFile('document.pdf');
$text = $pdf->getText();
echo $text;
运行上述代码后,变量`$text`将包含PDF中所有可见页面的纯文本内容。如果PDF包含扫描图片且未嵌入OCR层,提取结果可能为空或乱码。
如何将文本发送给Claude API
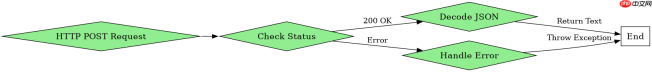
使用Guzzle HTTP客户端构建请求体,将提取的文本放入`messages`数组中发送给Anthropic API。需要设置正确的Header和JSON Payload。

$client = new \GuzzleHttp\Client();
$response = $client->post('https://api.anthropic.com/v1/messages', [
    'headers' => [
        'x-api-key' => 'your-api-key',
        'anthropic-version' => '2023-06-01',
        'content-type' => 'application/json'
    ],
    'json' => [
        'model' => 'claude-sonnet-4-20250514',
        'max_tokens' => 1024,
        'messages' => [['role' => 'user', 'content' => $text]]
    ]
]);
$body = json_decode($response->getBody(), true);
echo $body['content'][0]['text'];
API返回的JSON中包含`content`数组,其中第一个元素的`text`字段即为Claude的分析结果。若文本过长超过模型上下文窗口,需先进行分块处理。
如何处理大文件的文本截断问题
当PDF提取的文本长度超过Claude模型的上下文限制时,直接发送会导致请求失败或被截断。需要在发送前对文本进行切片或摘要预处理。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





