






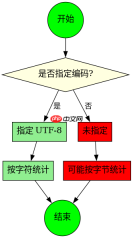
使用 mb_strlen 函数并指定 utf-8 编码参数即可正确统计中文字符数。默认情况下该函数可能按字节计算导致结果偏大,显式传入编码后它会按字符计数,返回的整数即为包含中文在内的总字符长度。

不指定编码时 mb_strlen 的行为差异是什么
当省略第二个参数时,mb_strlen 会使用当前内部编码(通常为 UTF-8),但在某些环境或旧版本中可能退化为单字节模式,导致中文被误判为多个字节。明确指定 UTF-8 可确保行为一致。
<?php // 示例输入
$str = "你好世界";

// 错误用法:依赖默认编码,可能出错
$wrong_len = mb_strlen($str);

// 正确用法:显式指定 UTF-8
$correct_len = mb_strlen($str, 'UTF-8');

echo "错误长度: " . $wrong_len . PHP_EOL;
echo "正确长度: " . $correct_len . PHP_EOL;
?>
预期输出:
错误长度: 8
正确长度: 4
如何处理非 UTF-8 编码的中文字符串
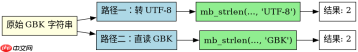
若字符串来自 GBK 或 ISO-8859-1 等编码源,需先转换为 UTF-8 再统计,或直接指定对应编码参数。直接对非 UTF-8 字符串用 UTF-8 模式统计会返回错误或乱码长度。

<?php // 假设 $gbk_str 是 GBK 编码的中文字符串
$gbk_str = mb_convert_encoding("测试", 'GBK', 'UTF-8');

// 方法一:转换后再统计
$utf8_str = mb_convert_encoding($gbk_str, 'UTF-8', 'GBK');
$len_utf8 = mb_strlen($utf8_str, 'UTF-8');

// 方法二:直接指定原编码
$len_gbk = mb_strlen($gbk_str, 'GBK');

echo "UTF-8 转换后长度: " . $len_utf8 . PHP_EOL;
echo "GBK 直接统计长度: " . $len_gbk . PHP_EOL;
?>
预期输出:
UTF-8 转换后长度: 2
GBK 直接统计长度: 2
空字符串或 null 输入时 mb_strlen 返回什么
传入空字符串 "" 时返回 0;传入 null 时会触发警告并返回 1(因 null 被转为字符串 "" 前可能产生意外行为,建议前置判断)。实际开发中应先校验类型避免异常。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


