






解决 nginx 代理超时提示 upstream timed out 的核心方法是调整 proxy_read_timeout、proxy_send_timeout 和 proxy_connect_timeout 参数,使其大于后端服务的实际处理耗时。如果后端服务本身响应缓慢,应优先优化后端代码或数据库查询;若后端正常但网络延迟高,可适当增大超时阈值并检查防火墙策略。
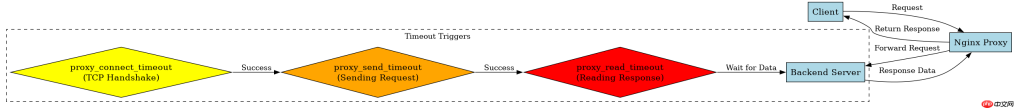
如何区分连接、发送和读取超时的具体场景
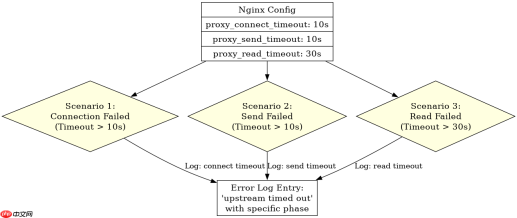
要解决超时问题,首先需要明确是哪一阶段导致的超时。proxy_connect_timeout 控制 Nginx 与后端建立 TCP 连接的等待时间,默认 60 秒,通常用于排查后端服务是否启动或端口是否可达。proxy_send_timeout 定义 Nginx 向后端发送请求数据的最大间隔,如果在指定时间内未写完数据,连接将断开。proxy_read_timeout 是最常见的超时原因,它规定 Nginx 等待后端返回响应数据的时长,一旦后端处理逻辑(如复杂 SQL 查询)超过此值,Nginx 就会主动切断连接并返回 504 错误。
server {
    listen 80;
    server_name example.com;

    location /api/ {
        # 设置连接超时为 10 秒
        proxy_connect_timeout 10s;
        # 设置发送请求头和数据超时为 10 秒
        proxy_send_timeout 10s;
        # 设置读取后端响应超时为 30 秒,根据业务需求调整
        proxy_read_timeout 30s;

        proxy_pass http://backend_server;
    }
}
如何通过日志定位具体的超时源头
当调整超时参数后,仍需通过日志确认问题是否彻底解决或是否存在间歇性超时。Nginx 的错误日志中会记录详细的超时信息,包括上游服务器 IP、端口以及具体的错误类型。通过分析 $upstream_response_time 变量,可以量化后端实际的处理耗时,从而判断当前的超时设置是否合理。如果日志显示大量 upstream prematurely closed connection,则可能是后端服务崩溃或网络中断,而非单纯的超时问题。


# 在 log_format 中添加 upstream_response_time
log_format main '$remote_addr - $remote_user [$time_local] "$request" '
                '$status $body_bytes_sent "$http_referer" '
                '"$http_user_agent" upstream_response_time=$upstream_response_time';

# 访问日志示例
192.168.1.1 - - [10/Oct/2023:13:55:36 +0000] "GET /api/data HTTP/1.1" 200 1234 "-" "curl/7.68.0" upstream_response_time=2.500
后端服务响应时间超过 30 秒时如何处理
当后端服务因复杂计算或大数据量导致响应时间超过默认的 30 秒甚至更长时,单纯增加 Nginx 的超时参数可能掩盖性能瓶颈。此时应结合后端日志分析具体耗时环节,例如数据库慢查询或外部 API 调用延迟。若业务允许,可引入缓存机制减少重复计算,或将长任务改为异步处理并通过轮询或 WebSocket 通知前端。同时,确保 Nginx 的 proxy_read_timeout 设置为略高于后端最大预期响应时间,以避免误报 504 错误。








