






在容器化部署中,nginx 代理超时的合理配置需要同时调整 proxy_connect_timeout、proxy_send_timeout 和 proxy_read_timeout,并将它们与容器的健康检查间隔及业务容忍度对齐。通常建议将连接超时设为 5-10 秒,发送和读取超时根据接口类型(如短接口或长轮询)分别设置为 30 秒到 60 秒,避免容器重启时出现大量 502/504 错误。通过 nginx.conf 中的 http 块统一设置这些参数,可以确保流量在容器生命周期内被正确管理。
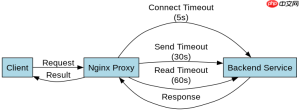
Nginx 代理超时参数的具体含义是什么
Nginx 的代理超时主要涉及三个核心参数:proxy_connect_timeout 定义建立后端连接的等待时间,proxy_send_timeout 定义向后端发送请求数据的允许时间,而 proxy_read_timeout 则定义从后端读取响应的等待时间。这三个参数共同决定了客户端在什么情况下会收到 502 Bad Gateway 或 504 Gateway Time-out 错误。在容器环境中,由于网络跳数增加和容器启动延迟,合理的默认值比单机部署更为关键。
server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_service;

        # 连接超时:等待后端建立连接的时间
        proxy_connect_timeout 5s;

        # 发送超时:向后端发送请求体的总时间
        proxy_send_timeout 30s;

        # 读取超时:等待后端返回响应体的总时间
        proxy_read_timeout 60s;

        # 其他必要配置
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
上述配置展示了在 location 块中设置超时的标准做法。proxy_connect_timeout 设为 5 秒,足以应对容器冷启动时的短暂延迟,但不会让客户端等待过久。proxy_send_timeout 设为 30 秒,适用于大多数 API 请求的数据传输。proxy_read_timeout 设为 60 秒,为后端处理复杂逻辑预留了充足时间。如果后端是长时间运行的任务,可能需要进一步调高 proxy_read_timeout。这些值应根据实际业务的 SLA 进行调整,避免过于激进导致误杀正常请求,或过于宽松导致资源浪费。
如何结合容器健康检查优化超时配置
在 Kubernetes 或 Docker Swarm 等编排系统中,Nginx 的超时配置必须与容器的健康检查机制协同工作。如果健康检查间隔短于 Nginx 的超时时间,可能导致在容器重启期间,Nginx 仍然将流量转发给不健康的实例,从而引发超时错误。因此,需要将 proxy_connect_timeout 设置为小于健康检查间隔的值,确保在健康检查失败后,Nginx 能迅速感知并停止转发流量。同时,proxy_read_timeout 应大于容器最大重启时间,以避免在重启过程中触发不必要的 504 错误。


# Kubernetes Service 示例
apiVersion: v1
kind: Service
metadata:
  name: backend-service
spec:
  selector:
    app: backend
  ports:
  - port: 80
    targetPort: 8080
---
# Deployment 示例
apiVersion: apps/v1
kind: Deployment
metadata:
  name: backend-deployment
spec:
  replicas: 3
  template:
    spec:
      containers:
      - name: backend
        image: backend-image:latest
        readinessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 5
          periodSeconds: 10
        livenessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 15
          periodSeconds: 20
在上述 Kubernetes 配置中,readinessProbe 的 periodSeconds 设为 10 秒,意味着每 10 秒检查一次容器是否就绪。Nginx 的 proxy_connect_timeout 应设为 5 秒,小于健康检查间隔,以确保在容器未就绪时,Nginx 能快速放弃连接尝试。同时,livenessProbe 的 initialDelaySeconds 设为 15 秒,给予容器足够的启动时间。这种配置确保了 Nginx 与容器生命周期的一致性,减少了因容器重启导致的代理超时问题。在实际生产中,还需监控 Nginx 的错误日志,根据实际超时情况微调这些参数。
当后端服务响应慢时,Nginx 会返回什么状态码
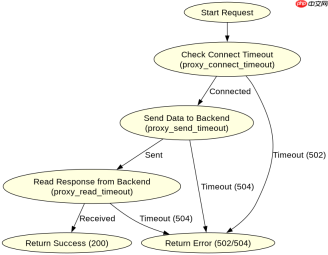
当后端服务响应慢,超过 Nginx 配置的 proxy_read_timeout 时,Nginx 会向客户端返回 504 Gateway Time-out 状态码。这是最常见的超时错误,表明 Nginx 在指定时间内未能从后端获取完整的响应。如果是在建立连接阶段超时,即超过 proxy_connect_timeout,Nginx 会返回 502 Bad Gateway 状态码。这两种状态码的区别在于超时发生的阶段:连接阶段还是数据传输阶段。开发者可以通过检查 Nginx 的错误日志来区分具体原因,日志中通常会记录具体的超时类型和后端地址。





