






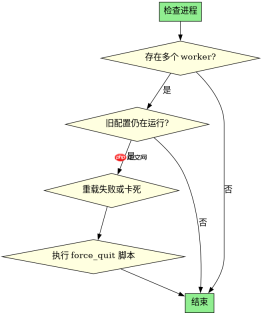
通过向 nginx 主进程发送 sigquit 信号可以强制其立即退出,从而终止旧进程。若需保留服务可用性并重新加载配置,应先使用 -s reload 触发平滑重载,观察旧进程是否因处理长连接或慢请求而滞留;若超时后仍不退出,再对主进程执行 kill -sigquit 强制关闭,nginx 会自动重启新实例接管流量。

如何确认旧进程未正常退出
检查 ps aux | grep nginx 输出中是否存在多个 worker 进程且 master 进程 PID 与预期不符,或通过 nginx -T 验证当前生效配置是否与部署版本一致。若发现旧配置仍在运行但新配置未生效,说明重载失败或旧进程卡死。
#!/bin/bash
# 检查 Nginx 状态
nginx_status() {
    if pgrep -x nginx >/dev/null; then
        echo "Nginx is running"
        ps aux | grep '[n]ginx'
    else
        echo "Nginx is not running"
    fi
}

# 尝试平滑重载
reload_nginx() {
    nginx -s reload
    sleep 2
    nginx_status
}

# 强制退出旧进程
force_quit() {
    kill -SIGQUIT $(pgrep -x nginx)
    sleep 1
    nginx_status
}

# 执行流程
reload_nginx
force_quit
上述脚本首先调用 nginx -s reload 触发重载,等待 2 秒后检查进程状态;若旧进程仍存在,则通过 kill -SIGQUIT 强制主进程退出,随后 Nginx 自动重启新进程。预期结果为:重载后旧进程应逐步停止,若未停止则强制退出后新进程启动并加载最新配置。
为什么旧进程会滞留不退出
旧进程滞留通常是因为正在处理长连接、慢查询或未正确关闭的文件描述符。Nginx 在收到 SIGHUP(即 reload)时,会通知旧 worker 进程停止接受新连接,但会继续处理现有请求直到完成。若请求处理时间超过系统设定的超时阈值,或存在资源泄漏,旧进程可能无法及时退出。


# 查看 Nginx 错误日志
journalctl -u nginx.service --since '10 minutes ago' | grep -i 'error\|timeout'

# 检查当前连接的客户端数量
ss -tnp | grep ':80\|:443' | wc -l

# 模拟长连接测试
curl -v http://localhost/long-running-endpoint &
sleep 5
kill %1
通过检查错误日志和活跃连接数,可定位导致旧进程滞留的具体原因。例如,若日志中出现大量 upstream timed out 错误,说明后端服务响应过慢,导致 Nginx worker 进程等待超时。此时应优化后端性能或调整 proxy_read_timeout 等参数。模拟长连接测试可复现问题,验证修复效果。
基于程序中某个输入、条件或结果的具体问题
当 proxy_read_timeout 设置为 60 秒,而后端服务响应时间为 70 秒时,Nginx 会在 60 秒后断开连接,但旧 worker 进程可能因未正确处理断开事件而滞留。此条件下,强制退出是唯一解决方案。





