





网页、图片或pdf里的文字不能直接选中时,可用faststone capture的capture text进行ocr识别。ocr即光学字符识别,会把截图中的可见文字转成可复制文本;该功能需要windows 10或windows 11。识别后的数字、链接和命令仍需对照原图复核。
打开Capture Text文字识别
先从设置菜单选择“文字识别”。启动FastStone Capture,单击工具栏最右侧的设置按钮,在下拉菜单中选择文字识别/Capture Text。当前功能依赖Windows 10/11的识别能力,旧系统看不到入口或无法工作时,应先确认系统版本。

框选需要识别的文字
① 拖动框住一段清晰文字。让十字光标从文字左上角拖到右下角,边界只包含要复制的段落。字号太小、背景纹理复杂或画面倾斜都会降低准确率;可先放大页面再框选,避免把图片、图标和无关栏目一起带入。

复制结果并逐字复核
② 在结果窗口按Ctrl+A、Ctrl+C。识别完成后,文字会出现在可编辑结果框中。先检查数字、日期、英文大小写和标点,再全选复制到Word、Excel或聊天窗口。账号、金额、命令和链接必须与原图逐字核对,不能只凭OCR结果直接使用。
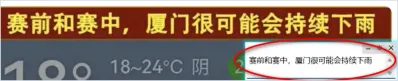
识别不完整时缩小范围重试
文字遗漏通常与字号、清晰度或选区过大有关。先把原页面放大到能看清字符,再只框选一段文字。复杂表格可分行识别;背景干扰严重时先提高截图对比度。仍有错字就以原图为准手动校正。
OCR结果可直接复制,但重要数字、链接和命令必须回看原图确认。









