





用wps文字,想一次性把文档里所有超链接、表格内容批量导出来,根本不用逐行手抄,第一步先搞清楚你的文档属于哪类:要是本身就是可编辑的原始文字文档,优先用查找、代码或者导出功能批量拿链接;要是拍照扫描件、图片类的资料,先做文字识别,再导出表格。路子选对了,效率直接高一大截。
先分清你手里的是“可编辑文档”还是“扫描型文档”
很多人上来就直接全选内容复制,很容易卡在两个地方:要么超链接太多,人工一个个点开核对又慢还容易漏;要么所谓的表格其实是扫描页里的图片,看着像表格,根本选不中、复制不了。这两类文档处理逻辑完全不一样,所以第一步先确认,你的文档是不是原生就能编辑的内容。
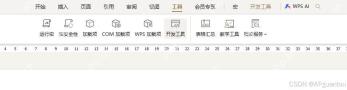
如果光标能直接点进正文,拖动选中的是正常文字、能点进表格单元格,那就是可编辑文档;要是页面看起来就是一整张图,选不中任何单独的文本,那就得走识别提取的路线。先做完这步判断,能少走很多冤枉路。
提取超链接时,优先走批量查看代码或宏处理
原生WPS文字文档里的超链接,最麻烦的是到处分散——正文、目录、注释、引用区域里都可能藏着,普通复制经常只能拿到显示的文字,拿不到背后的完整网址。这种情况别逐段翻着找,直接从文档对象、代码层面读取所有超链接集合,稳得多。
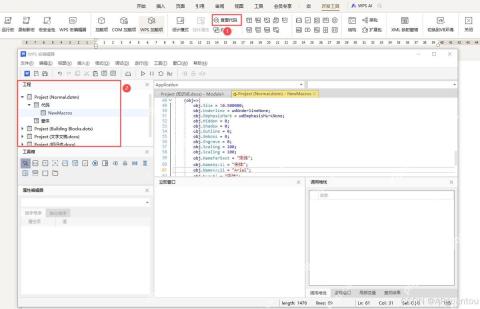
实际操作就分两步:
- 先确认文档里的是插入好的超链接对象,不是别人直接敲进去的纯文本网址。
- 用代码或者宏把所有链接地址统一导出来,不用一页页人工复制。
这个方法特别适合链接多、章节多,还得保留原始完整URL的场景,比如制度汇编、资料手册、项目清单、课程讲义这类。只要文档本身是原生可编辑的,批量导出比手工复制靠谱太多。
如果文档来自扫描件,先做电子化识别再谈表格提取
很多人要提取表格内容,根本不是从现成的Word表格里抄数据,是想把扫描页里的表格转成可编辑内容。这时候你还在WPS文字正文里翻复制按钮,完全没用。正确的做法是先走扫描识别流程,把内容转成结构化的可编辑数据,之后再按需导出表格、导出文字,或者做后续的数据清洗。
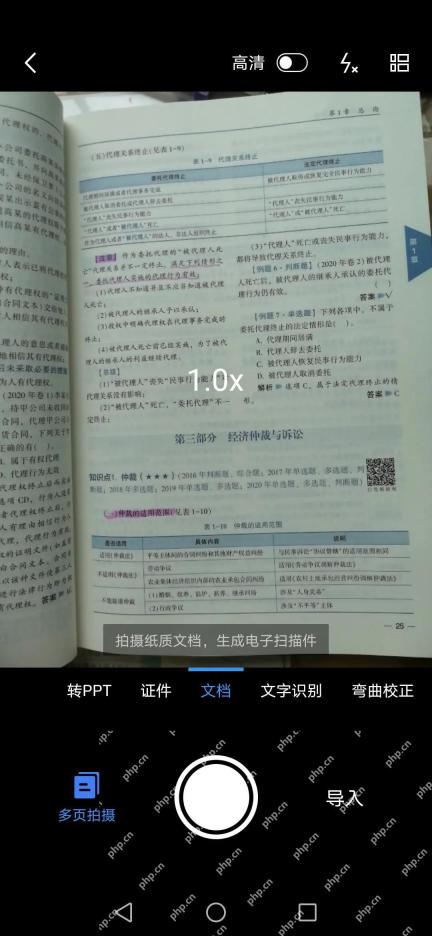
这步别着急点导出,先确认识别完的页面,有没有把页码、段落、表格区域分对。只要页面结构识别得没大问题,后面提取表格内容的准确率会高很多。
多页文档提取表格时,先选页再点“提取表格”
扫描资料经常几十页,不是每页都有表格。要是一上来就整份文档全导出,最后肯定混进去一大堆没用的无关文字。更省事的做法是,先在页面缩略图里把真的带表格的页面勾出来,单独针对这些页做表格识别、提取,既能减少误识别,后面逐页核对也方便。

{"answer":"协助 macOS 用户准备、转换、导出及排查 Word、PDF、Markdown、PowerPoint 和 Excel 文件,确保 WPS Office 工作流程可靠。"}
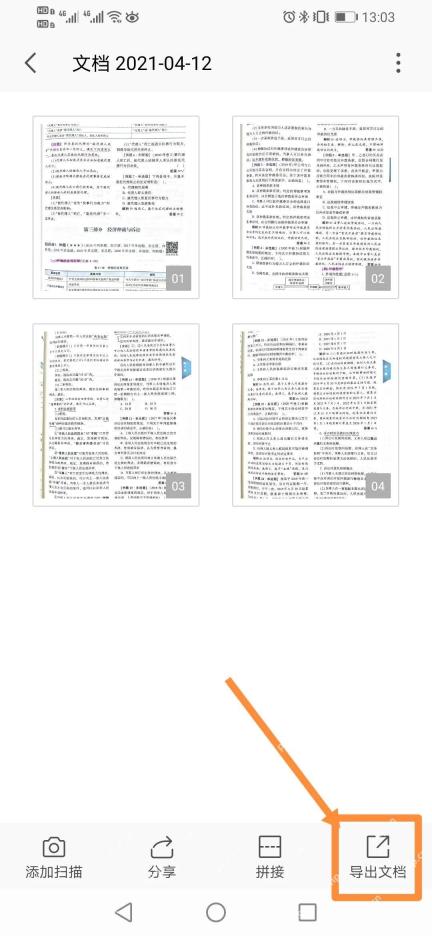
如果文档里既有普通文字页,又有表格页,建议把表格页单独挑出来导出处理,别和普通文字页混在一起。后面不管你要导去Excel,还是整理成汇总表,都省心很多。
导出前别选错格式,避免把可提取内容又压回死文件
做识别提取的时候,很多人踩过这个坑:好不容易把内容识别完,最后手滑直接导出成PDF或者图片,结果下一步要处理还得重新识别一遍。我们提取表格的目的,本来就是要拿到能复制、能整理、能汇总的可用数据,所以导出阶段优先选能继续编辑的格式,别光想着要保留原版的版式外观。
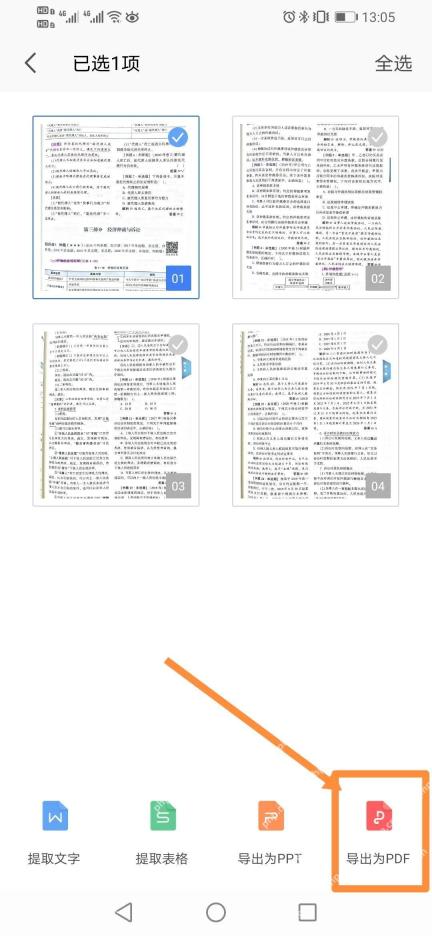
要是你后面还要接着整理表格,优先选能随便复制粘贴、能直接转成表格数据的格式;只有最终要归档、要发给别人分享的时候,再导出成PDF。这点想明白,能少做很多无用功。
表格识别完成后,要先核对再批量复制
不管是扫描页识别出来的表格,还是直接从文档结构里导出来的表格内容,刚出结果的时候别直接默认100%准确。识别工具对合并单元格、长文本换行、金额列、日期列的识别经常出点小问题,所以提取完先别急着全选复制,先预览一遍表格结构,看是整表直接用,还是分块调整后再用。
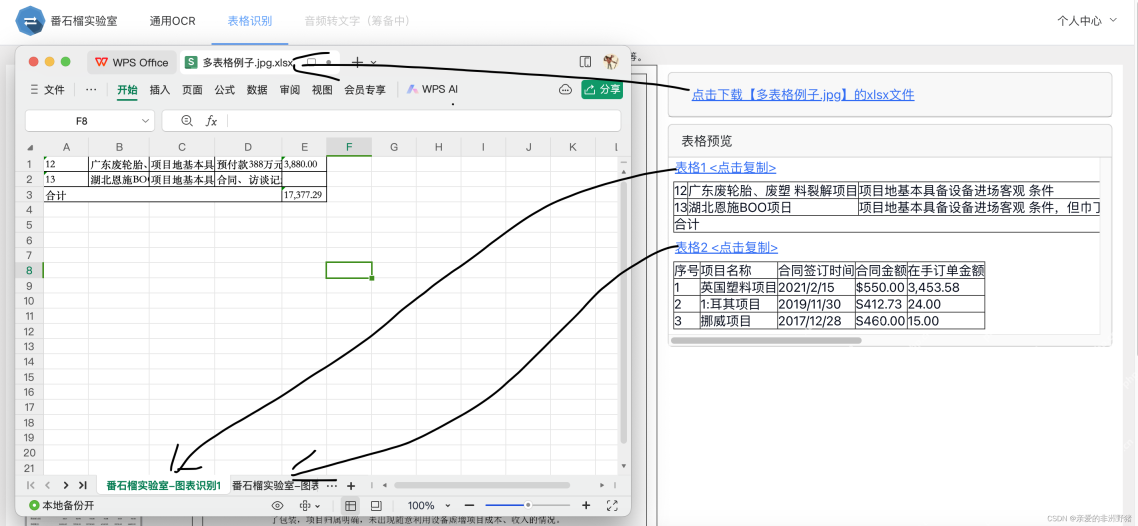
稳妥的收尾流程就三步:
- 先抽查表头、金额列、日期列和合计行有没有识别错位。
- 确认没问题之后,再整表复制,或者按需拆成多张表分开存。
- 如果你之前还导出了超链接,建议把链接文件和表格文件分开存,后面整理的时候不会乱。
用WPS文字批量提取文档里的超链接和表格内容,最省时间的核心根本不是找什么一键搞定的万能按钮,而是先判断清楚文档类型,再选对应的处理方法:原生可编辑文档就批量读取超链接对象,扫描型资料就先做识别再导出表格。路子选对了,后面提取、校对、整理全流程都顺得多。


