






Oracle Data Guard发生裂脑时该如何紧急恢复
生产环境中oracle data guard发生裂脑(split-brain)时,必须立即停止所有数据库的写入操作,通过检查v$database.instantiation_scn或v$archived_log确定哪个节点拥有最新数据,然后以该节点为主库进行恢复。具体做法是:在确认主库后,使用flashback database将备库回退到裂脑前的scn,并重新建立物理备用关系;若无法闪回,则需对备库执行基于主库备份的全库恢复。此过程会丢失裂脑期间产生的部分事务数据,因此首要任务是止血并尽快恢复服务。

如何判断哪个节点是真正的“主库”
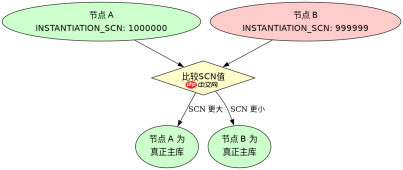
判断裂脑后的真正主库,核心依据是Current SCN或最后应用的归档日志序列号。拥有更高SCN的节点通常保留了更多业务数据,应作为恢复的目标主库。如果两个节点的SCN相同,则需比较最后接收/应用的归档日志序列号,序列号大的节点更可能是主库。在实际操作中,可以通过查询V$DATABASE.INSTANTIATION_SCN视图来获取每个实例的实例化SCN,这是判断数据一致性的关键指标。
SELECT INSTANTIATION_SCN FROM V$DATABASE;
上述SQL语句在两个节点上分别执行。假设节点A返回1000000,节点B返回999999,则节点A拥有更新的数据,应保留为活跃主库。节点B则需要被降级并重新同步。务必确保在做出决定前,两个节点都处于MOUNT状态或只读状态,严禁同时开放读写权限,否则会导致数据进一步分裂。

如何将备库重新同步到主库
一旦确定了目标主库,下一步是将另一侧的节点(原备库)重新配置为物理备用库。最快速的方法是使用FLASHBACK DATABASE功能。首先,在主库上创建一个 Guaranteed Restore Point,记录当前的SCN。然后,在备库上执行闪回操作,将其回退到与主库一致的SCN。闪回完成后,重新启动备库的实时应用进程(Real-Time Apply),即可恢复Data Guard同步。

-- 在主库创建恢复点<br>CREATE RESTORE POINT pre_split_brain GUARANTEE FLASHBACK DATABASE;<br><br>-- 在备库执行闪回<br>SHUTDOWN IMMEDIATE;<br>STARTUP MOUNT;<br>FLASHBACK DATABASE TO RESTORE POINT pre_split_brain;<br>ALTER DATABASE CONVERT TO PHYSICAL STANDBY;<br>SHUTDOWN IMMEDIATE;<br>STARTUP MOUNT;<br>ALTER DATABASE RECOVER MANAGED STANDBY DATABASE USING CURRENT LOGFILE DISCONNECT;<br>
如果备库因为时间过长导致闪回区空间不足,无法执行闪回,则必须采用全库恢复方式。这需要使用主库的最新备份文件,在备库上进行还原和恢复。虽然耗时较长,但能确保数据一致性。恢复完成后,同样启动实时应用进程,使备库开始从主库接收并重做日志。在整个过程中,监控V$DATAGUARD_STATS视图,确保延迟(Transport Lag)和恢复延迟(Apply Lag)逐渐降低至零,标志着同步恢复正常。


