






在oracle 23ai中,可以通过查询动态性能视图 v$diag_ash 来诊断向量检索的延迟。具体做法是编写sql查询该视图,筛选出与向量操作相关的会话和事件,并统计等待时间。这样做可以获取向量检索操作的详细耗时分布和瓶颈信息。如果存在大量等待,通常意味着i/o或cpu资源不足。

如何识别向量检索相关的等待事件?
要识别向量检索相关的等待事件,需要关注 V$DIAG_ASH 中的 EVENT 列。在Oracle 23ai中,向量搜索通常涉及特定的内部操作,这些操作可能会表现为 SQL*Net message from client 或其他I/O相关的等待事件。通过过滤这些事件,可以定位到具体的向量检索请求。
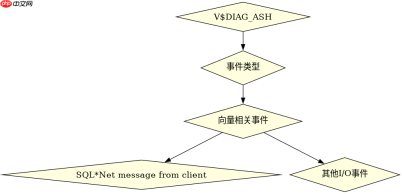
-- 查询V$DIAG_ASH以识别向量检索相关的等待事件
SELECT event, COUNT(*) as wait_count, SUM(wait_time) as total_wait_time
FROM V$DIAG_ASH
WHERE event LIKE '%vector%' OR event LIKE '%search%'
GROUP BY event
ORDER BY total_wait_time DESC;
上述查询将返回与向量检索相关的等待事件及其总等待时间。根据结果,可以进一步分析哪些事件导致了主要的延迟。
如何分析向量检索的延迟分布?
分析向量检索的延迟分布,可以使用 V$DIAG_ASH 中的 WAIT_TIME 和 P1、P2 等参数。这些参数提供了更详细的等待信息,例如等待的具体原因或相关对象。通过分析这些数据,可以了解向量检索在不同阶段的耗时情况。

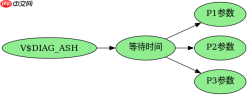
-- 分析向量检索的延迟分布
SELECT event, p1, p2, p3, COUNT(*) as sample_count, AVG(wait_time) as avg_wait_time
FROM V$DIAG_ASH
WHERE event LIKE '%vector%' OR event LIKE '%search%'
GROUP BY event, p1, p2, p3
ORDER BY avg_wait_time DESC;
此查询将展示向量检索过程中各个阶段的平均等待时间和样本数量。这有助于识别出耗时最长的阶段,从而进行针对性优化。
基于程序中某个输入、条件或结果的具体问题:如何处理高并发下的向量检索延迟?
在高并发场景下,向量检索延迟可能会显著增加。为了处理这种情况,可以考虑使用并行查询、调整数据库参数或优化索引。例如,启用并行执行可以提高向量检索的速度。此外,确保向量索引的正确构建和维护也是关键。


