navicat中字段重复值很多(低区分度)时,不建议盲目建立索引。对于只有两三种取值且分布均匀的布尔或状态字段,普通b-tree索引往往无法有效减少查询扫描量,反而会增加写入开销和存储成本;此时应优先考虑覆盖索引、复合索引优化或调整sql逻辑。
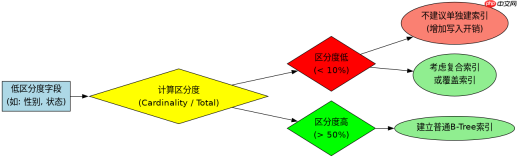
如何判断字段是否适合单独建索引
判断依据是区分度(Cardinality),即字段唯一值的数量与总行数的比例。如果区分度低于某个阈值(如5%-10%),单独索引通常无效。在Navicat中,可以通过查看表属性中的统计信息或使用特定SQL语句来获取这一数据。
SELECT
  TABLE_NAME,
  COLUMN_NAME,
  CARDINALITY,
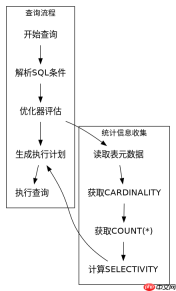
  (CARDINALITY / (SELECT COUNT(*) FROM table_name)) AS SELECTIVITY
FROM
  INFORMATION_SCHEMA.COLUMNS
WHERE
  TABLE_SCHEMA = 'your_database'
  AND TABLE_NAME = 'your_table';
运行上述SQL后,若发现某字段的SELECTIVITY极低,例如一个“性别”字段(男/女)在百万级表中区分度仅为0.5,则说明该字段不适合单独建立普通索引。此时,数据库优化器在执行`WHERE gender = 'male'`时,可能认为全表扫描比走索引更快,从而忽略索引。
低区分度字段在复合索引中的正确用法
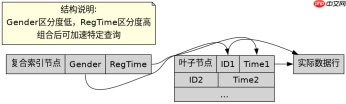
虽然低区分度字段不适合单独建索引,但它可以作为复合索引的前导列或后续列,具体取决于查询模式。如果查询经常同时涉及“性别”和“注册时间”,可以将两者结合建立复合索引。

Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。
-- 假设查询场景:查找所有男性用户中最近注册的前10名
-- 错误做法:单独为gender建索引
CREATE INDEX idx_gender ON users(gender);

-- 推荐做法:建立复合索引,将高区分度字段放在前面
CREATE INDEX idx_reg_time_gender ON users(reg_time, gender);

-- 或者,如果gender过滤能大幅缩小范围且reg_time用于排序
CREATE INDEX idx_gender_reg_time ON users(gender, reg_time);
在MySQL等数据库中,复合索引遵循最左前缀原则。如果“性别”字段的区分度很低,但“注册时间”的区分度很高,将`reg_time`放在前面通常能获得更好的过滤效果。然而,如果业务逻辑是先按性别分组,再在组内按时间排序,那么`idx_gender_reg_time`可能更合适。关键在于理解查询的执行计划,而非单纯依赖字段类型。
基于程序中某个输入、条件或结果的具体问题
当程序传入一个具体的低区分度参数(如`status=1`)进行查询时,即使建立了索引,执行计划也可能显示为全表扫描。这是因为优化器估算出返回的数据行数超过了总行数的一个百分比(通常是15%-20%以上),认为全表扫描更高效。
要验证这一点,可以在Navicat中使用`EXPLAIN`命令分析查询。如果看到`type`列为`ALL`或`index`,且`rows`预估扫描行数很大,说明索引未被使用。此时,强制使用索引(`FORCE INDEX`)通常不是最佳解决方案,因为它可能导致随机I/O增加。更好的做法是检查是否有其他高区分度的过滤条件可以加入,或者考虑使用覆盖索引来避免回表,从而提升整体性能。