Navicat怎么查看字段实际占用的最大长度
在navicat中查看字段实际占用的最大长度,最准确的方法是直接在查询窗口执行sql统计语句。通过运行包含max(length())函数的查询,可以获取指定列中非空数据的最大字符数或字节数。这种方法比依赖表结构定义的“最大允许长度”更能反映真实的数据存储情况,适用于排查数据截断风险或优化存储空间。

如何区分字符长度与字节长度
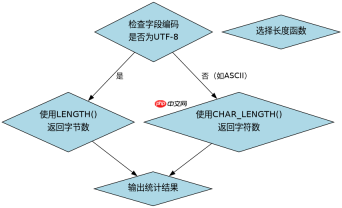
区分字符长度和字节长度的关键在于使用不同的函数:LENGTH()返回字节数,而CHAR_LENGTH()返回字符数。对于UTF-8编码的中文或特殊符号,两者结果往往不同。例如,一个汉字在UTF-8下通常占用3个字节,因此LENGTH()的结果会是CHAR_LENGTH()的三倍左右。明确这一区别有助于正确评估数据库空间的实际消耗。

Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。
如何处理NULL值对统计的影响
在使用MAX()函数时,必须注意NULL值的处理逻辑。MAX()会自动忽略NULL值,只计算非空记录中的最大值。如果某列全部为NULL,则返回NULL。若需将NULL视为0或特定默认值参与比较,应先用IFNULL()或COALESCE()进行转换。此外,空字符串''与NULL不同,LENGTH('')返回0,会被纳入MAX()的计算范围,这可能导致统计结果偏小,需根据业务需求决定是否过滤空字符串。
digraph G { rankdir=LR; node [shape=box, style=filled, fillcolor=lightyellow, fontname="Microsoft YaHei", fontsize=16]; edge [fontname="Microsoft YaHei", fontsize=14]; Start [label="开始统计字段长度"]; Connect [label="连接目标数据库"]; SelectTable [label="选择包含目标字段的表"]; WriteQuery [label="编写SQL查询语句\nSELECT MAX(LENGTH(col)) FROM table"]; Execute [label="执行查询"]; ViewResult [label="查看返回的最大值"]; End [label="结束"]; Start -> Connect; Connect -> SelectTable; SelectTable -> WriteQuery; WriteQuery -> Execute; Execute -> ViewResult; ViewResult -> End; } # 完整程序:统计字段最大长度
SELECT
    column_name,
    MAX(LENGTH(column_name)) AS max_byte_length,
    MAX(CHAR_LENGTH(column_name)) AS max_char_length,
    COUNT(*) AS total_rows,
    SUM(CASE WHEN column_name IS NULL THEN 1 ELSE 0 END) AS null_count
FROM
    your_table_name
GROUP BY
    column_name;
预期结果:
- max_byte_length: 该列所有非空值中,按字节计算的最大长度。
- max_char_length: 该列所有非空值中,按字符计算的最大长度。
- total_rows: 表中总行数。
- null_count: 该列为NULL的行数。
注意:请将your_table_name替换为实际表名,column_name替换为目标字段名。
digraph G {
rankdir=TB;
node [shape=diamond, style=filled, fillcolor=lightblue, fontname="Microsoft YaHei", fontsize=16];
edge [fontname="Microsoft YaHei", fontsize=14];
CheckEncoding [label="检查字段编码\n是否为UTF-8"];
ChooseFunction [label="选择长度函数"];
ByteLength [label="使用LENGTH()\n返回字节数"];
CharLength [label="使用CHAR_LENGTH()\n返回字符数"];
Result [label="输出统计结果"];
CheckEncoding -> ByteLength [label="是"];
CheckEncoding -> CharLength [label="否(如ASCII)"];
ByteLength -> Result;
CharLength -> Result;
}
# 对比示例:UTF-8编码下的长度差异
-- 假设字段 'content' 存储了中文文本
SELECT
    content,
    LENGTH(content) AS byte_len,
    CHAR_LENGTH(content) AS char_len
FROM
    articles
WHERE
    id = 1;
预期结果: - 若content为"你好",则byte_len为6,char_len为2。 - 若content为"Hello",则byte_len为5,char_len为5。 此示例展示了UTF-8编码下中英文长度计算的差异。 digraph G { rankdir=TB; node [shape=ellipse, style=filled, fillcolor=lightgreen, fontname="Microsoft YaHei", fontsize=16]; edge [fontname="Microsoft YaHei", fontsize=14]; QueryStart [label="执行MAX(LENGTH(col))"]; NullCheck [label="遇到NULL值?"]; IgnoreNull [label="忽略NULL,继续比较"]; ReturnMax [label="返回非空值的最大值"]; AllNull [label="全部为NULL?"]; ReturnNull [label="返回NULL"]; EmptyString [label="遇到空字符串''"]; IncludeZero [label="包含0,参与比较"]; QueryStart -> NullCheck; NullCheck -> IgnoreNull [label="是"]; NullCheck -> ReturnMax [label="否"]; IgnoreNull -> ReturnMax; ReturnMax -> AllNull; AllNull -> ReturnNull [label="是"]; AllNull -> ReturnMax [label="否"]; ReturnMax -> EmptyString; EmptyString -> IncludeZero; IncludeZero -> ReturnMax; }