






在 ansible playbook 中配置批量变更后的验证,核心做法是利用 block 和 rescue 结构将变更任务与验证任务绑定。当变更任务执行失败时,ansible 会自动跳过 rescue 块;若变更成功但后续验证任务失败,则触发回滚逻辑或标记主机为不可用,从而确保状态一致性。

如何定义变更与验证的依赖关系
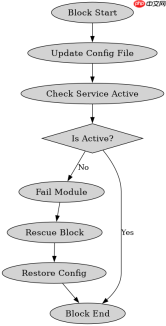
通过 block 和 rescue 可以建立强依赖。变更操作放在 block 中,验证操作紧随其后。如果变更步骤出错,整个 block 中断,不会执行验证。如果变更成功但验证失败,可以通过 rescue 捕获异常并执行回滚或告警。
---
- hosts: webservers
  tasks:
    - name: Apply configuration change
      block:
        - name: Update config file
          template:
            src: myapp.conf.j2
            dest: /etc/myapp/myapp.conf
          notify: Restart service

        - name: Verify service is running
          command: systemctl is-active myapp
          register: svc_status
          changed_when: false

        - name: Fail if verification fails
          fail:
            msg: "Service is not active after change"
          when: svc_status.stdout != 'active'

      rescue:
        - name: Rollback on failure
          debug:
            msg: "Change failed or verification failed. Rolling back..."

        - name: Restore original config
          copy:
            content: "# Original Config"
            dest: /etc/myapp/myapp.conf

      always:
        - name: Notify monitoring
          debug:
            msg: "Task execution completed."
上述代码展示了完整的流程:首先应用模板,然后检查服务状态。如果 systemctl is-active 返回非 active,则 fail 模块触发错误,进入 rescue 块进行回滚。这种结构确保了只有在变更和验证都成功后,Playbook 才会继续执行后续任务。
如何处理并发执行中的状态不一致
在批量变更场景下,并发执行可能导致部分主机验证通过而其他主机失败。使用 serial 关键字可以控制批次大小,结合 max_fail_percentage 确保整体成功率。此外,可以使用 delegate_to 将验证任务委托给一个稳定的控制节点,避免在被控节点状态不稳定时验证失败。

---
- hosts: all_servers
  serial: 10%
  max_fail_percentage: 20
  tasks:
    - name: Deploy new version
      shell: |
        cd /opt/app && ./deploy.sh v2.0
      register: deploy_result
      changed_when: deploy_result.rc == 0

    - name: Verify deployment on control node
      delegate_to: localhost
      uri:
        url: "http://{{ inventory_hostname }}:8080/health"
        method: GET
        status_code: 200
      register: health_check
      retries: 3
      delay: 5
      until: health_check.status == 200

    - name: Handle failed verification
      fail:
        msg: "Health check failed for {{ inventory_hostname }}"
      when: health_check.status != 200
该示例中,serial: 10% 确保每次只更新 10% 的主机,max_fail_percentage: 20 允许最多 20% 的主机失败。验证任务通过 delegate_to: localhost 从本地发起 HTTP 健康检查,避免了在被控节点重启期间直接登录验证的问题。如果健康检查连续 3 次失败,则标记该主机验证失败,触发回滚或人工干预。
基于健康检查接口返回的具体问题
当健康检查接口返回非 200 状态码时,Playbook 会立即终止当前主机的后续任务并进入 rescue 或 fail 分支。具体而言,如果 uri 模块返回的状态码不是 200,when: health_check.status != 200 条件成立,fail 模块抛出错误,导致该主机被标记为失败。由于设置了 max_fail_percentage,如果失败比例超过阈值,整个 Playbook 将中止,防止更多主机被部署到错误状态。











