






litellm 升级后出现 mcp 工具消失、健康检查不可用或启动失败,可能与新版默认安全行为有关。排查时先判断失败发生在登录、工具发现、工具调用还是进程启动阶段,保留同一时间段的日志和请求编号,再针对性处理。
先区分预期拒绝与真正故障
| 现象 | 先核对 | 后续处理 |
|---|---|---|
| 已有 stdio 记录仍在,工具却消失 | stdio 是否保持默认关闭。 | 确认业务依赖,选择调整工具部署或受控保留。 |
| 调用返回 403 | 关闭策略、Key/Team 授权、上游拒绝。 | 定位响应来自哪一层。 |
| 同一请求偶发成功 | Pod 版本、开关和授权配置是否一致。 | 逐实例关联请求和日志。 |
| 进程立即退出 | 主密钥检查、数据库连接及迁移。 | 读取启动早期日志。 |
| UI 可登录但模型失败 | 已保存凭据能否解密,上游密钥是否有效。 | 核对密钥与数据库,不先改工具协议。 |
工具不见了,先看 transport 和开关
根据官方说明,在具备默认关闭机制的版本中,未显式启用 stdio 时,已有配置可以继续列出,但工具不会启动或加入列表。创建、更新和直接调用也会受到限制。使用 HTTP/SSE 的工具需要沿各自连接路径另外检查。
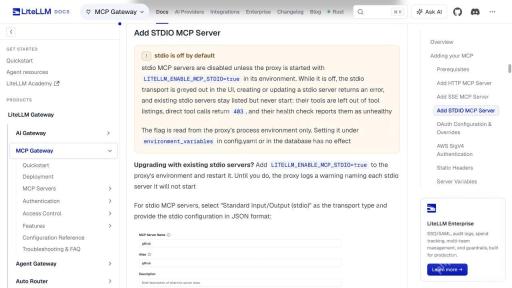
在实际代理容器中读取安装版本和目标开关。以下假设容器名为 gateway,适用于镜像内提供 python 命令的部署。
docker exec gateway python -c 'from importlib.metadata import version; import os; print(version("litellm")); print(os.getenv("LITELLM_ENABLE_MCP_STDIO", "<unset>"))'
docker logs --since=15m gateway</unset>
如果业务不使用 stdio,保持关闭并清理调用端对这些工具的依赖。如果确有需要,先评估管理员权限和工具进程隔离,再批准相应变更;单纯为消除健康告警而启用主机执行能力,会改变部署的风险条件。
403 从哪一层返回?
保留完整状态码、响应结构、请求 ID 和时间,对照反向代理与 LiteLLM 的记录。如果请求未进入代理日志,先检查入口认证和网络策略;代理接收后拒绝,则检查开关、Key、Team、组织以及具体工具权限。
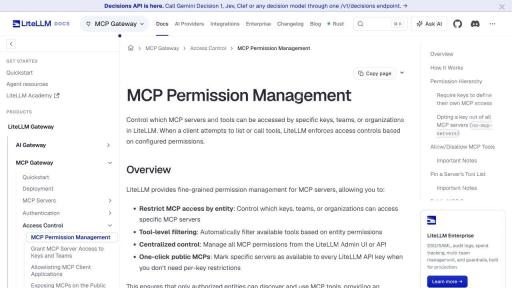
最后查看远程 MCP 服务是否拒绝了它所需的独立认证。LiteLLM 的虚拟密钥与远程服务的凭据承担不同职责,应逐层确认。错误响应里含有敏感 Header 或凭据时,工单只保存脱敏版本。
用两个授权范围已知的测试身份对照列表与调用,确认是所有工具失败还是某个工具失败。保留已验证的 server_id、工具名及环境,不凭显示名称猜测对应配置。
多副本偶发错误怎么定位?
给每次失败记录接收请求的 Pod 或实例,比较镜像摘要、进程启动时间和开关值。共享数据库并不代表所有实例读取了相同启动环境,配置变更也未必触发容器重建。
kubectl -n ai-gateway get pods -l app=litellm -o wide
kubectl -n ai-gateway rollout status deployment/litellm --timeout=300s
kubectl -n ai-gateway logs POD_NAME --since=15m
把命名空间、标签和 POD_NAME 替换为实际资源。确认旧副本退出,再从相同业务身份重复请求。若依赖 GitOps,继续检查声明源是否覆盖了紧急修改。
进程拒绝启动,按早期日志处理
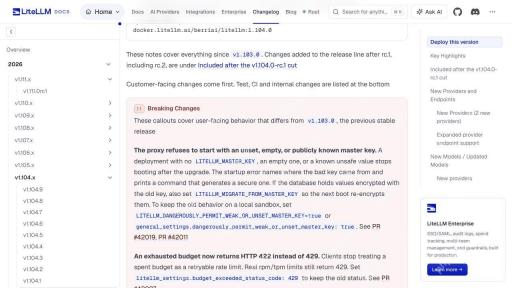
新版对缺失、空白或已知不安全 master key 的处理更加严格。先核实值的来源是环境变量还是配置文件,确认配置固定值没有覆盖秘密存储。对承担数据库加密职责的旧密钥,要先安排迁移,才能更换并恢复读写。
如果报数据库迁移失败,检查数据库可达性、连接权限和迁移工具输出,保留首次错误。先解决连接或 schema 状态,不通过关闭检查让应用继续处理可能不一致的数据。已有部分迁移的情况,应按当前版本流程恢复并验证。
上游工具超时怎样缩小范围?
在代理实际网络环境检查目标地址、DNS、证书链和网络出口。用自有远程 MCP 的健康接口先做普通连通性验证,再使用对应 transport 的正常协议请求测试;普通 GET 成功不能证明 MCP 初始化、列工具和工具调用都成功。
区分工具初始化超时、单工具执行慢和代理入口超时,比较同一请求在两端的时间。若设置了远程服务独立认证,核对凭据是否过期,以及代理是否转发了预期 Header。保持证书校验,正确安装受信任 CA 后再复测。
如何结束排错工单?
至少完成一个正常模型请求、一次获准的远程工具调用,以及一个应被拒绝的身份测试。把版本、transport、实例、授权范围和响应结果放在同一条记录中,另附启动日志中已解决的错误。
仍无法定位时,提交最小合法请求、脱敏配置、版本、部署形态和双方日志。标明是否启用了 stdio、是否设置 salt key、是否有多副本及最近的迁移,便于维护者复现相同环境。
用最小请求区分模型故障和工具故障
选用已有授权、成本可控的测试模型,先执行不携带工具的普通请求。模型请求正常后,再单独测试远程 MCP 的初始化和工具列表,最后执行一个无副作用的工具调用。每一步保留时间、请求编号和接收实例。
只有带工具的请求失败时,继续检查工具名、server_id、命名空间前缀和授权。模型请求也失败时,先解决网关认证、数据库凭据解析或上游模型可达性,避免同时修改多个无关配置。
配置保存成功,重启后为什么还原?
检查相关对象究竟由数据库还是静态文件管理,并确认当前版本的优先级。共享数据库实例也可能使用不同 config.yaml。把保存后的值与重启后实际读取的值对照,核对管理 API 请求是否被发到另一套环境。
对由 Helm 或 GitOps 管理的环境,在声明源修正后重新发布;对数据库保存的对象,确认有持久化和正确的数据库连接。不能以浏览器表单显示成功就认定所有 worker 已加载更新。
哪些证据最适合提供给支持人员?
保存最小脱敏配置,列出部署形态、镜像摘要、是否多副本、存储方式、transport 和实际错误阶段。对同一请求同时提供入口和后端日志,敏感 Prompt、响应内容与认证头按组织规定脱敏。
若经过多次尝试已无法追踪配置变化,先冻结变更并导出当前受控状态,再在隔离环境用相同版本重建。不要把生产所有密钥复制到重现场景,只提供完成最小验证所需的测试材料。













