






在人工智能模型参数规模持续飙升的当下,动辄数万亿参数的超大规模模型通常依赖昂贵的高端gpu集群才能运行。然而,最近一位技术爱好者在社区发布了一项充满极客气质的极限实验:他仅使用一台未配备独立显卡、搭载40核cpu的老款服务器,成功让月之暗面推出的2.8万亿参数大模型 kimi k3 实现了实际运行。
突破硬件边界:超大规模模型登陆古董级服务器
作为一款结构复杂的混合专家模型(MoE),Kimi K3 的总参数量高达2.8万亿,但每个 token 仅动态激活约1040亿参数;其官方宣称支持的最大上下文长度更是达到104万 token。
如此庞大的参数体量,即便采用极致压缩的1bit量化方案,仍需数百GB内存方可容纳,远超常规消费级主板的内存承载能力。为绕过这一物理限制,该玩家另辟蹊径,选用一颗Intel第三代至强可扩展处理器,并搭配早已停产的英伟达傲腾持久内存(Optane Persistent Memory)200系列——该系列单条最高支持512GB容量,成为本次方案的关键硬件支点。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
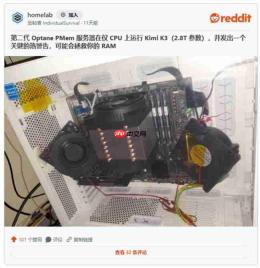
创新软件协同:将停产品牌傲腾内存“改造成”主存
在软硬件协同层面,该玩家借助开源推理框架 llama.cpp,将傲腾持久内存配置为 App Direct 模式,使其脱离传统存储角色,直接以内存形式被程序读写,而非交由操作系统作为缓存层进行间接管理。

基于计算机视觉和大语言模型,对图像内容进行开放式问答,支持任意问题获得自然语言回答。
当然,这种非标准、低成本的平民化部署方式也伴随着明显的性能折损:
生成速率:在1bit量化下,实测吞吐量仅为0.85 token/秒;若关闭直接访问(DAX)模式,峰值速度也仅提升至1.5 token/秒。
响应延迟:当采用3bit量化时,生成速率进一步降至约0.75 token/秒。这意味着输出几百字需耗费数分钟;若要生成5万个 token,则需连续运行长达18.5小时。
散热压力:傲腾硬件自身的功耗与温控特性亦构成严峻挑战。据英伟达公开规格文档,该代傲腾内存单条最大功耗为18瓦;当模组温度升至83℃时即启动降频机制,一旦触及85℃红线,系统将强制触发保护性关机。
需要指出的是,英伟达早在2022年第二季度就已开始逐步退出傲腾内存业务,当季计提了高达5.59亿美元的库存减值损失。这也意味着该产品线已无后续迭代计划。此次运行不仅是一次对硬件边界的试探,更像是一场献给技术信仰的硬核致敬,以及对极端资源约束下AI可行性的一次真实验证。





