





要是你手头的名单、编码、分类数据散在excel的好几列里,直接筛选特别麻烦,很多人想先把所有内容拼到一起再去掉重复值。这种场景下,先用tocol把多列内容压成单列,再用unique提取不重复结果,比手动复制拼接省太多事。
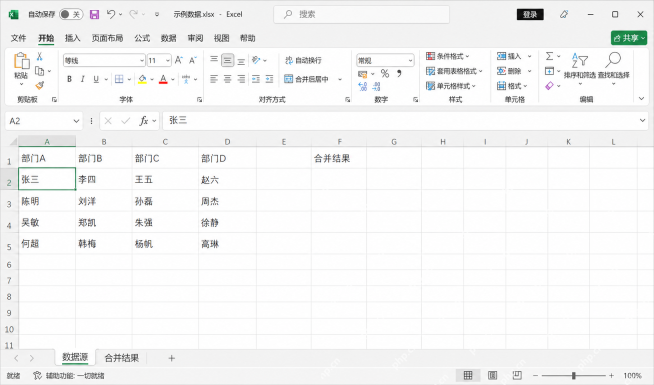
先看原始数据区域:如果同类型的数据分散在A到D这好几列里,首要问题根本不是“怎么去重”,而是“怎么先把这些列的内容收拢成一列”。你先确定好要处理的源区域,比如A2:D5这一段,后面所有公式都围绕这个区域写就行。
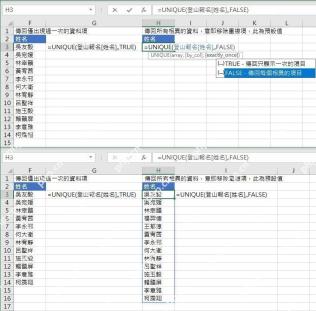
实际用的时候直接把两个函数嵌套起来就很顺手,比如在结果区域输入 =UNIQUE(TOCOL(A2:D5,1))。其中TOCOL的作用,是把A2:D5里的内容按顺序压平成单列;第二个参数填1,可以顺带忽略所有空白单元格。外层再套UNIQUE,就能直接从压平后的名单里返回所有不重复结果,一步搞定多列合并+去重两个需求。

诊断并修复涉及公式、命名范围、Power Query 刷新、数据透视表、VBA/宏保存等问题的 Microsoft Excel XLSX 工作簿
如果你的数据本身已经全在同一列,单独用UNIQUE就够了;但只要数据分散在多列、多个不连续区块,或者表头结构比较复杂,TOCOL这一步就很关键。实际操作的时候,建议先单独运行TOCOL出结果,确认内容顺序没问题了,再把UNIQUE套上去,出问题的时候也更容易判断是压平环节还是去重环节出了错。
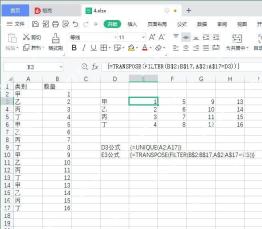
如果最后还想把去重后的结果横向摆放到同一行里,可以在外层再加一个TRANSPOSE,写成类似 =TRANSPOSE(UNIQUE(TOCOL(A2:D5,1)))。不过就“快速提取不重复数据”这个目标来说,核心逻辑还是先用TOCOL把多列整理成单列,再交给UNIQUE输出最终结果。这么处理完,名单、部门、分类标签这类数据,后续做统计和引用都会方便很多。


