






节点重启后 task 丢失通常是因为 docker swarm 的调度器在节点恢复前将任务标记为失败并尝试在其他节点重新调度,或者因资源不足导致任务无法立即启动。要解决这个问题,需要确保集群有足够的可用资源,并检查节点的 raft 状态和日志以排除持久化存储或网络分区问题。
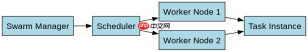
如何确认丢失的 Task 是否被重新调度
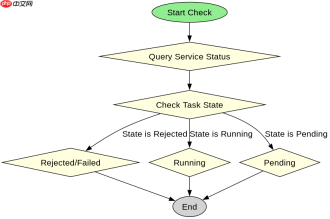
可以通过查询 Swarm 集群中所有服务的状态来确认丢失的任务是否已被重新分配。使用 docker service ps 命令可以查看特定服务下所有任务的详细状态,包括当前运行在哪个节点、之前的状态以及错误信息。如果任务显示为 Rejected 或 Shutdown,则说明调度器未能成功将其放置到任何节点上。
docker service ps my_app_service
NAME                IMAGE               NODE                DESIRED STATE       CURRENT STATE           ERROR               PORTS
my_app_service.1    my_image:latest     worker-1            Running             Running 5 minutes ago
my_app_service.2    my_image:latest     -                   Shutdown            Rejected 10 minutes ago   "no resources available"
上述输出显示任务 2 处于 Rejected 状态,原因是 no resources available。这表明集群中没有足够的 CPU 或内存资源来启动该任务。此时应检查其他节点的资源使用情况,或增加集群规模。
为什么节点重启后部分 Task 会进入 Pending 状态
当节点重启时,Swarm 管理器(Manager)会暂时失去与该节点的连接,并将该节点上的任务标记为 Down。随后,调度器会尝试在其他健康节点上重新调度这些任务。如果目标节点资源不足或存在约束冲突,任务就会进入 Pending 状态。此外,如果使用了本地卷(local volumes)且未配置多节点共享存储,任务可能因无法挂载卷而保持 Pending。

通过 Docker 或 docker compose 部署独立的 LYGO 协议栈社区节点。构建 lygo-node镜像,启动健康检查 API 于端口 8787,可选 Phase 4...

docker node ls
ID                    HOSTNAME            STATUS              AVAILABILITY        MANAGER STATUS      ENGINE VERSION
abc123                manager-1           Ready               Active              Leader              20.10.7
def456                worker-1            Down                Active                                  20.10.7
ghi789                worker-2            Ready               Active                                  20.10.7
在上面的示例中,worker-1 处于 Down 状态,这可能导致其上的任务无法正常恢复。管理员应等待节点重新加入集群,或手动清理卡住的任务。
基于节点状态为 Down 时的具体处理步骤
当发现节点状态为 Down 时,应首先尝试让节点重新上线。如果节点无法自动恢复,则需要手动干预。可以使用 docker node update --availability drain 将节点标记为不可用,从而停止向其调度新任务。然后,使用 docker service update --force 强制重新部署服务,以确保任务在其他健康节点上重新启动。最后,检查节点日志以排查重启原因。


