






容器内 dns 解析慢通常是因为 docker 默认使用的宿主机 dns 配置在容器网络中不可达或响应延迟高,解决办法是手动指定一个稳定且低延迟的公共 dns(如 8.8.8.8)或在宿主机层面优化 resolv.conf。具体做法是在启动容器时通过 --dns 参数注入 dns 服务器地址,或者修改 docker 守护进程的配置文件 daemon.json 来全局生效,这样能绕过宿主机可能存在的递归查询瓶颈,直接获得快速响应。
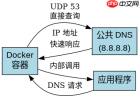
Docker 默认 DNS 转发机制为何导致延迟
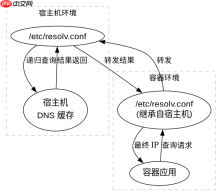
Docker 容器默认使用宿主机的 /etc/resolv.conf 作为 DNS 配置来源,这会导致容器内的查询请求被转发到宿主机,再由宿主机进行递归查询。如果宿主机配置的 DNS 服务器响应慢或存在网络波动,这种“二传手”模式会显著增加解析耗时。
{
  "dns": ["8.8.8.8", "114.114.114.114"]
}
上述配置写入 /etc/docker/daemon.json 后重启 Docker 服务,所有新建容器将自动使用指定的公共 DNS。这种方式避免了依赖宿主机不稳定的 DNS 设置,直接连接外部权威或递归服务器,从而降低解析延迟。验证方法是在容器内执行 nslookup example.com 并观察返回时间,若明显缩短则说明优化有效。
如何验证容器内 DNS 解析性能
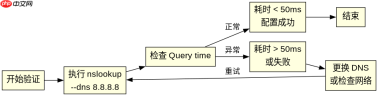
验证 DNS 性能需要对比不同配置下的解析耗时,重点检查是否因 DNS 超时导致应用启动缓慢。可以通过在容器中安装 dnsutils 或使用内置的 nslookup 命令进行基准测试,记录首次和多次查询的平均响应时间。

通过 Docker 或 docker compose 部署独立的 LYGO 协议栈社区节点。构建 lygo-node镜像,启动健康检查 API 于端口 8787,可选 Phase 4...
docker run --rm -it --dns 8.8.8.8 alpine nslookup google.com
该命令启动一个临时 Alpine 容器并强制使用 8.8.8.8 作为 DNS 服务器,输出结果中的 Query time 字段即为解析耗时。若该值低于 50ms 且无 server failed 错误,表明 DNS 配置正常。对于生产环境,建议将此配置固化到 Docker Compose 文件或 Kubernetes Service 定义中,确保一致性。
容器内 DNS 查询失败时的应急处理
当 DNS 解析完全失败或间歇性中断时,通常是因为网络策略限制了 UDP 53 端口访问,或者 DNS 服务器本身不可用。此时应检查容器网络模式是否为 host 或 bridge,并确认防火墙规则未阻断 DNS 流量。
应急处理包括临时在容器内修改 /etc/resolv.conf 指向本地缓存 DNS,或切换至 TCP 53 端口进行查询以绕过 UDP 限制。若问题持续,需排查宿主机网络路由及上游 DNS 服务的健康状态,必要时更换为更可靠的 DNS 提供商。


