






java 中读写 gzip 压缩大文件的标准做法是使用 gzipoutputstream 和 gzipinputstream,并将它们分别包裹在 fileoutputstream 和 fileinputstream 之外。通过这种流式处理,程序可以一边读取源数据一边写入压缩块,无需将整个文件加载到内存中,从而避免 outofmemoryerror。

如何高效实现大文件的压缩与解压
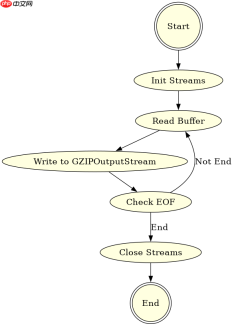
针对大文件,核心策略是维持一个固定大小的缓冲区(例如 8KB),在循环中不断从输入流读取数据并写入输出流,直到读取结束。这种方式能确保内存占用恒定,且充分利用 CPU 进行实时压缩或解压。
import java.io.*;
import java.util.zip.GZIPInputStream;
import java.util.zip.GZIPOutputStream;

public class GzipBigFile {
    private static final int BUFFER_SIZE = 8192;

    public static void compress(String srcPath, String destPath) throws IOException {
        try (FileInputStream fis = new FileInputStream(srcPath);
             GZIPOutputStream gzos = new GZIPOutputStream(new FileOutputStream(destPath))) {
            byte[] buffer = new byte[BUFFER_SIZE];
            int len;
            while ((len = fis.read(buffer)) != -1) {
                gzos.write(buffer, 0, len);
            }
        }
    }

    public static void decompress(String srcPath, String destPath) throws IOException {
        try (GZIPInputStream gzis = new GZIPInputStream(new FileInputStream(srcPath));
             FileOutputStream fos = new FileOutputStream(destPath)) {
            byte[] buffer = new byte[BUFFER_SIZE];
            int len;
            while ((len = gzis.read(buffer)) != -1) {
                fos.write(buffer, 0, len);
            }
        }
    }
}
上述代码展示了完整的压缩和解压逻辑。在 compress 方法中,GZIPOutputStream 会自动计算 CRC32 校验和并写入文件头尾的元数据。在 decompress 方法中,GZIPInputStream 会跳过文件头,直接返回原始字节流。使用 try-with-resources 确保流在使用后自动关闭,防止资源泄漏。
如何处理压缩过程中的异常与进度监控
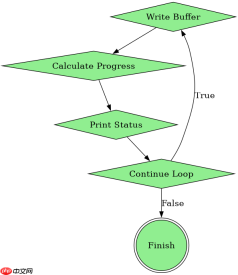
在处理大文件时,网络中断或磁盘空间不足可能导致 IOException。为了增强健壮性,可以在写入循环中加入简单的进度打印,并在捕获异常时提供明确的错误信息。此外,如果需要在多线程环境下处理多个小文件,可以考虑复用 GZIPOutputStream 实例,但需注意同步问题。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
import java.io.*;
import java.util.zip.GZIPInputStream;
import java.util.zip.GZIPOutputStream;

public class GzipWithProgress {
    private static final int BUFFER_SIZE = 8192;

    public static void compressWithProgress(File src, File dest) throws IOException {
        long totalBytes = src.length();
        long writtenBytes = 0;
        try (FileInputStream fis = new FileInputStream(src);
             GZIPOutputStream gzos = new GZIPOutputStream(new FileOutputStream(dest))) {
            byte[] buffer = new byte[BUFFER_SIZE];
            int len;
            while ((len = fis.read(buffer)) != -1) {
                gzos.write(buffer, 0, len);
                writtenBytes += len;
                if (totalBytes > 0) {
                    System.out.printf("Compressed: %.2f%%\n", (writtenBytes * 100.0 / totalBytes));
                }
            }
        }
    }
}
这段代码在压缩过程中添加了进度监控。通过 src.length() 获取源文件大小,并在每次写入后更新已写入字节数。虽然 GZIPOutputStream 内部有缓冲,但这里的进度是基于原始数据的读取量计算的,对于用户感知来说足够准确。如果在实际运行中遇到 java.util.zip.ZipException: Not in GZIP format,通常是因为尝试解压非 GZIP 格式的文件,或者文件在传输过程中损坏。
当 GZIP 压缩率不理想时该如何调整参数
GZIPOutputStream 默认使用 Deflater.DEFAULT_COMPRESSION(值为 -1),这通常在速度和压缩率之间取得平衡。如果需要更高的压缩率,可以通过构造函数传入 Deflater 对象来设置压缩级别。例如,使用 Deflater.BEST_COMPRESSION 可以获得更小的文件体积,但会显著增加 CPU 消耗和时间。反之,Deflater.NO_COMPRESSION 仅用于封装而不进行压缩,适用于需要快速打包的场景。
import java.io.*;
import java.util.zip.Deflater;
import java.util.zip.GZIPOutputStream;

public class GzipTuning {
    public static void compressHighQuality(String srcPath, String destPath) throws IOException {
        try (FileInputStream fis = new FileInputStream(srcPath);
             GZIPOutputStream gzos = new GZIPOutputStream(
                 new FileOutputStream(destPath),
                 new Deflater(Deflater.BEST_COMPRESSION))) {
            byte[] buffer = new byte[8192];
            int len;
            while ((len = fis.read(buffer)) != -1) {
                gzos.write(buffer, 0, len);
            }
        }
    }
}
通过传入自定义的 Deflater,开发者可以精细控制压缩行为。需要注意的是,高压缩级别会导致内存占用略有增加,因为 Deflater 需要维护更大的滑动窗口。在实际应用中,应根据文件类型(如文本、图片、日志)和业务需求选择合适的压缩级别。对于已经压缩过的文件(如 JPEG、MP4),再次使用 GZIP 压缩效果甚微,甚至可能增大文件体积。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


