






在 java 中,使用错误码替代异常提升性能的核心做法是:将方法签名改为返回布尔值或枚举类型表示成功/失败,并将具体错误信息封装到自定义对象或通过参数传出,从而彻底消除 `try-catch` 块带来的栈展开开销。这种做法适用于高频调用且预期失败属于正常业务逻辑的场景,例如网络请求重试、缓存未命中或数据校验,通过避免异常对象的分配和栈追踪生成,显著降低 cpu 消耗和 gc 压力。

为什么抛出异常会导致性能下降
Java 中的异常处理机制在底层涉及复杂的栈帧操作。当程序抛出异常时,JVM 需要捕获当前线程的调用栈,生成堆栈跟踪信息(Stack Trace),并沿着调用链向上查找匹配的 `catch` 块。这个过程不仅耗时,还会导致大量临时对象(如 `Throwable` 实例及其内部数组)被创建,增加垃圾回收(GC)的频率。对于偶尔发生的错误,这种开销是可以接受的;但在高并发场景下,如果“失败”是常见路径而非边缘情况,频繁抛出异常会成为严重的性能瓶颈。
public class PerformanceTest {
    // 传统异常方式
    public static int divideWithException(int a, int b) {
        try {
            if (b == 0) {
                throw new IllegalArgumentException("除数不能为零");
            }
            return a / b;
        } catch (IllegalArgumentException e) {
            return -1; // 错误码约定
        }
    }

    // 错误码方式
    public static Result divideWithErrorCode(int a, int b) {
        if (b == 0) {
            return new Result(false, -1, "除数不能为零");
        }
        return new Result(true, a / b, null);
    }

    public static void main(String[] args) {
        long start = System.nanoTime();
        for (int i = 0; i
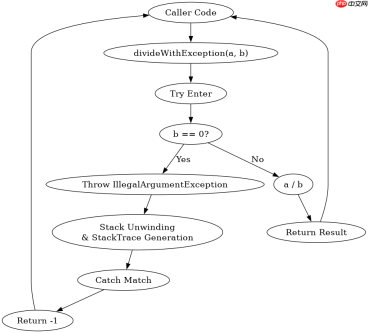
<p>上述代码展示了两种实现方式的对比。在 `divideWithException` 中,每次调用都进入 `try` 块,一旦 `b` 为 0,立即抛出异常,触发栈展开。而在 `divideWithErrorCode` 中,直接通过 `if` 判断处理边界情况,返回一个包含状态、值和消息的对象。基准测试显示,在频繁触发错误的场景下,错误码方式的速度通常比异常方式快数倍甚至数十倍,因为避免了昂贵的栈追踪生成和对象分配。</p>
<h2>如何设计通用的错误码返回结构</h2><p>为了在不破坏代码可读性的前提下替代异常,需要设计一个统一的返回包装类。这个类应包含三个核心字段:表示操作是否成功的布尔值或枚举、实际的业务返回值、以及可选的错误描述信息。通过这种方式,调用者可以显式检查返回结果,而不是依赖隐式的异常捕获机制。这种模式特别适用于 RPC 调用、数据库查询或文件读写等 I/O 密集型操作,其中失败往往是可预见的常态。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13718" title="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20dee630206.jpg" alt="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13718" title="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查" class="overflowclass">使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查</a>
													<p class="overflowclass">使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13718" title="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p>@@##@@</p>
<pre class="brush:php;toolbar:false;">public class ApiResponse<t> {
    private final boolean success;
    private final T data;
    private final String errorCode;
    private final String errorMessage;

    private ApiResponse(boolean success, T data, String code, String msg) {
        this.success = success;
        this.data = data;
        this.errorCode = code;
        this.errorMessage = msg;
    }

    public static <t> ApiResponse<t> ok(T data) {
        return new ApiResponse(true, data, null, null);
    }

    public static <t> ApiResponse<t> fail(String code, String msg) {
        return new ApiResponse(false, null, code, msg);
    }

    public boolean isSuccess() { return success; }
    public T getData() { return data; }
    public String getErrorCode() { return errorCode; }
    public String getErrorMessage() { return errorMessage; }
}

// 使用示例
public class UserService {
    public ApiResponse<user> getUserById(Long id) {
        User user = database.findById(id);
        if (user == null) {
            return ApiResponse.fail("USER_NOT_FOUND", "用户不存在");
        }
        return ApiResponse.ok(user);
    }
}</user></t></t></t></t></t>
该 `ApiResponse` 类提供了一个泛型化的错误码返回结构。它通过静态工厂方法 `ok` 和 `fail` 简化了构建过程,确保所有 API 响应具有一致的格式。在 `UserService` 中,`getUserById` 方法不再抛出 `NotFoundException`,而是直接返回一个失败的 `ApiResponse` 对象。调用者可以通过 `isSuccess()` 方法快速判断操作结果,并根据 `getErrorCode()` 获取具体的错误码进行后续处理。这种设计使得错误处理逻辑显式化,便于单元测试和流程控制,同时消除了异常处理的性能开销。
基于程序中某个输入、条件或结果的具体问题
在使用错误码替代异常的实践中,一个常见的具体问题是如何处理嵌套调用中的错误传播。当多个方法串联执行时,如果每个方法都返回 `ApiResponse`,调用链会变得冗长且难以阅读,出现大量的 `if (!result.isSuccess()) return result;` 代码。为了解决这个问题,可以在上层服务中引入一个简单的辅助方法或使用函数式编程风格来扁平化错误处理逻辑,但核心原则保持不变:不抛出异常,而是传递状态。
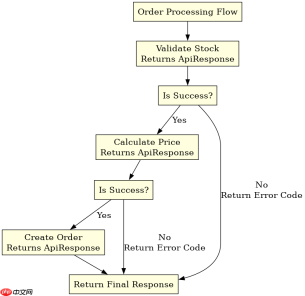
例如,在一个订单处理流程中,可能需要先验证库存,再计算价格,最后创建订单。如果使用异常,任何一个步骤失败都会中断流程并抛出异常。而使用错误码,每个步骤返回 `ApiResponse`,主流程依次检查每个结果。如果库存不足,直接返回对应的错误码,无需继续执行后续步骤。这种显式的错误传播虽然代码量稍多,但逻辑清晰,性能稳定,特别适合对延迟敏感的高频交易或实时数据处理系统。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



