






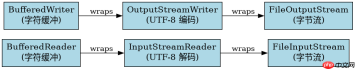
使用编码缓冲提升读写性能的核心做法是避免在每次字符与字节转换时都进行系统调用或重复计算,而是通过 bufferedreader 和 bufferedwriter 包装底层流,并配合指定字符集(如 utf-8)的 inputstreamreader 和 outputstreamwriter。这种组合能显著减少 i/o 次数,同时利用内部缓冲区缓存已解码的字符或待编码的字节,从而提升吞吐量。
如何配置带缓冲的字符流以处理 UTF-8 数据
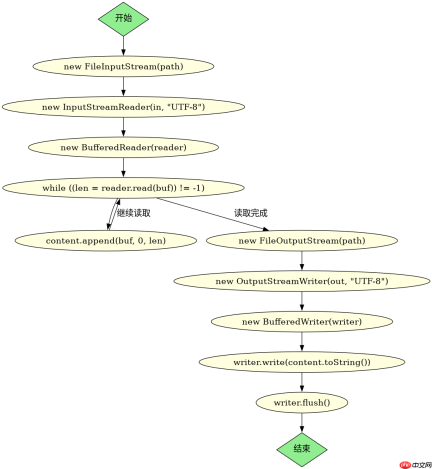
直接回答:要配置带缓冲的字符流,需将 FileInputStream 包裹在 InputStreamReader 中指定 "UTF-8",再将该 Reader 包裹在 BufferedReader 中;写入时同理,使用 FileOutputStream、OutputStreamWriter 和 BufferedWriter。这样做可以利用默认或自定义的缓冲区大小(通常 8KB)来批量处理数据,减少底层文件操作的频率。
import java.io.*;

public class EncodingBufferDemo {
    public static void main(String[] args) throws IOException {
        String inputPath = "input.txt";
        String outputPath = "output.txt";

        // 读取:FileInputStream -> InputStreamReader(UTF-8) -> BufferedReader
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(new FileInputStream(inputPath), "UTF-8"))) {
            StringBuilder content = new StringBuilder();
            char[] buffer = new char[1024];
            int len;
            while ((len = reader.read(buffer)) != -1) {
                content.append(buffer, 0, len);
            }
            System.out.println("Read content length: " + content.length());

            // 写入:FileOutputStream -> OutputStreamWriter(UTF-8) -> BufferedWriter
            try (BufferedWriter writer = new BufferedWriter(
                    new OutputStreamWriter(new FileOutputStream(outputPath), "UTF-8"))) {
                writer.write(content.toString());
                writer.flush();
            }
        }
    }
}
预期结果:程序成功读取 input.txt 中的 UTF-8 文本,将其内容长度打印到控制台,并将相同内容写入 output.txt。由于使用了缓冲,实际的文件 I/O 操作次数远少于字符数量,提升了效率。
为什么缓冲能提升字符编码转换的性能
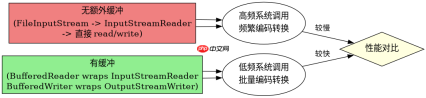
直接回答:缓冲提升性能是因为它减少了 InputStreamReader 和 OutputStreamWriter 频繁调用底层字节流的次数。字符编码转换(如 UTF-8 的多字节到 Unicode 码点映射)涉及复杂的查表或算法,如果每次只读/写一个字节或字符,都会触发多次转换逻辑和系统调用。缓冲区累积一定数量的数据后一次性转换, amortizes(分摊)了转换开销。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
import java.io.*;

public class BufferSizeComparison {
    public static void main(String[] args) throws IOException {
        String inputPath = "large_input.txt";
        String outputPath = "large_output.txt";

        long startNoBuffer = System.nanoTime();
        try (InputStreamReader rawReader = new InputStreamReader(new FileInputStream(inputPath), "UTF-8");
             OutputStreamWriter rawWriter = new OutputStreamWriter(new FileOutputStream(outputPath), "UTF-8")) {
            char[] buf = new char[100];
            int len;
            while ((len = rawReader.read(buf)) != -1) {
                rawWriter.write(buf, 0, len);
            }
        }
        long endNoBuffer = System.nanoTime();
        System.out.println("No extra buffer time: " + (endNoBuffer - startNoBuffer) / 1_000_000.0 + " ms");

        long startWithBuffer = System.nanoTime();
        try (BufferedReader bufferedReader = new BufferedReader(
                new InputStreamReader(new FileInputStream(inputPath), "UTF-8"));
             BufferedWriter bufferedWriter = new BufferedWriter(
                new OutputStreamWriter(new FileOutputStream(outputPath), "UTF-8"))) {
            char[] buf = new char[1024];
            int len;
            while ((len = bufferedReader.read(buf)) != -1) {
                bufferedWriter.write(buf, 0, len);
            }
        }
        long endWithBuffer = System.nanoTime();
        System.out.println("With buffer time: " + (endWithBuffer - startWithBuffer) / 1_000_000.0 + " ms");
    }
}
预期结果:对于大文件,With buffer time 显著小于 No extra buffer time。这验证了 BufferedReader 和 BufferedWriter 通过内部缓冲减少了底层 I/O 和编码转换的调用频率,从而提升了整体性能。
当缓冲区大小设置为 0 时会发生什么
直接回答:当缓冲区大小设置为 0 时,BufferedReader 和 BufferedWriter 的行为退化为几乎无缓冲,每次 read() 或 write() 都会尝试从底层流获取或释放数据,导致性能接近未使用缓冲的情况,甚至可能因频繁的系统调用而更差。这是因为缓冲区大小为 0 意味着没有额外的内存空间来累积数据,失去了缓冲的意义。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



