






Java 字符编码怎么用 ISO-8859-1 处理二进制
在 java 中,使用 iso-8859-1 处理二进制数据的核心方法是利用其单字节映射特性,将原始字节无损地转换为 string 对象。具体做法是在读取或写入时指定 standardcharsets.iso_8859_1 作为字符集,这样每个字节的值会直接对应 unicode 的 u+0000 到 u+00ff 范围,不会发生任何编码转换或替换。这样做的好处是可以在需要字符串操作(如正则匹配、子串提取)的场景下安全地持有二进制数据,同时保证通过 getbytes(standardcharsets.iso_8859_1) 转换回字节数组时,数据完全一致。
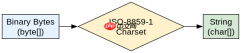
如何将 InputStream 中的二进制流无损转为 String
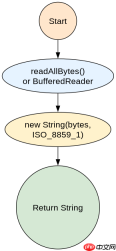
要将输入流中的二进制数据无损转换为 String,必须确保读取过程中不改变字节顺序和值。推荐使用 InputStream.readAllBytes() 获取所有字节后,立即用 ISO-8859-1 构造字符串。这种方法避免了逐字节处理的开销,且能正确处理包含空字节或高位字节的完整二进制块。如果数据量极大,可以使用 BufferedReader 配合 InputStreamReader 并指定 ISO-8859_1 进行分块读取,但需注意缓冲区边界对齐问题,通常全量读取更稳妥。
import java.io.IOException;
import java.io.InputStream;
import java.nio.charset.StandardCharsets;

public class BinaryToString {
    public static void main(String[] args) throws IOException {
        // 模拟二进制数据:包含中文UTF-8字节序列和特殊控制符
        byte[] binaryData = new byte[] {
            (byte) 0xE4, (byte) 0xB8, (byte) 0xAD, // '中' 的 UTF-8
            (byte) 0x00,                           // 空字节
            (byte) 0xFF                            // 高位字节
        };

        // 1. 将字节数组通过 ISO-8859-1 转为 String
        String str = new String(binaryData, StandardCharsets.ISO_8859_1);
        System.out.println("String length: " + str.length()); // 输出 5
        System.out.println("Char at 0: " + Integer.toHexString(str.charAt(0))); // E4
        System.out.println("Char at 3: " + Integer.toHexString(str.charAt(3))); // 0
        System.out.println("Char at 4: " + Integer.toHexString(str.charAt(4))); // FF

        // 2. 验证无损转回
        byte[] recovered = str.getBytes(StandardCharsets.ISO_8859_1);
        boolean isSame = java.util.Arrays.equals(binaryData, recovered);
        System.out.println("Recovery successful: " + isSame); // true
    }
}
为什么不能用 UTF-8 直接处理任意二进制
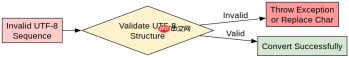
使用 UTF-8 处理非文本二进制数据会导致数据损坏或抛出异常,因为 UTF-8 是多字节编码,要求字节序列必须符合特定的结构规则。当遇到非法的 UTF-8 序列(如孤立的高位字节或错误的组合)时,String 构造函数默认会抛出 MalformedInputException,或者在使用 CharsetDecoder 时可以选择替换为问号 '?',这都会导致原始二进制信息丢失。相比之下,ISO-8859-1 是单字节编码,对任何 0-255 的字节值都合法,因此是唯一能“透明”承载任意二进制数据的字符集。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
import java.io.UnsupportedEncodingException;
import java.nio.charset.StandardCharsets;

public class Utf8FailureDemo {
    public static void main(String[] args) {
        // 非法的 UTF-8 序列:0xFF 不是有效的 UTF-8 起始字节
        byte[] invalidUtf8 = new byte[] { (byte) 0xFF, (byte) 0x00 };

        try {
            // 这会抛出 MalformedInputException 或在某些 JDK 版本中静默失败
            String str = new String(invalidUtf8, StandardCharsets.UTF_8);
            System.out.println("Converted to: " + str);
        } catch (Exception e) {
            System.out.println("Error: " + e.getClass().getSimpleName());
        }

        // 对比 ISO-8859-1 成功转换
        String safeStr = new String(invalidUtf8, StandardCharsets.ISO_8859_1);
        System.out.println("ISO-8859-1 result: " + Integer.toHexString(safeStr.charAt(0)));
    }
}
基于程序中某个输入、条件或结果的具体问题
在上述代码中,当输入包含空字节(0x00)时,ISO-8859-1 转换后的 String 长度保持不变,且可以通过索引准确访问该位置。这是一个关键特性,因为许多二进制协议(如网络包、文件头)中包含空字节作为分隔符或填充。如果使用其他编码方式,空字节可能被截断或误解,而 ISO-8859-1 确保了每个字节都有一个对应的 char 值,从而保留了数据的完整性。在实际应用中,这意味着你可以安全地对这类字符串进行子串操作,只要最终需要还原二进制时再次使用相同的字符集即可。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


