在navicat中统计每个分类的数据量,核心做法是使用sql的group by子句配合count聚合函数。你需要编写select语句,指定分类字段和count(*)或count(主键),并在末尾加上group by分类字段即可得到结果。若需过滤特定条件,可在查询前添加where子句。

如何编写基础的分组计数SQL
基础分组计数只需选定目标表和分类列,使用COUNT函数统计行数并按该列分组。执行该查询将返回一个包含分类名称和对应数量的结果集,其中NULL值会被单独归为一组。
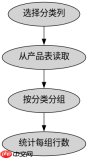
SELECT category, COUNT(*) AS count FROM products GROUP BY category;
如何处理分组中的空值与排序
当分类字段存在NULL值时,GROUP BY会将其视为一个独立的组进行统计。为了优化结果展示,通常建议对计数结果进行降序排列,以便快速查看高频分类。同时可以使用COALESCE函数将NULL显示为默认文本。

Navicat Premium 17.1
下载
Navicat Premium 17.1 Windows x64 历史系列获取入口。该系列扩展 Garnet、PolarDB 等连接支持,并增强可视化查询解释与 Redis 树视图;未核实到公开固定安装包直链。
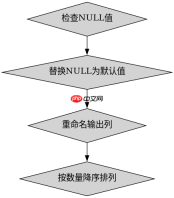
SELECT COALESCE(category, 'Unknown') AS cat_name, COUNT(*) AS cnt FROM products GROUP BY category ORDER BY cnt DESC;
如果只统计特定状态下的数据量该如何操作
若需统计特定状态下(如“已上架”)的分类数据量,需在GROUP BY之前加入WHERE条件过滤。这样COUNT函数仅对满足条件的行进行计数,未匹配的行将被排除在统计之外。