






在服务器硬件配置中,存储介质的选择直接决定了系统的响应速度和扩展能力。面对固态硬盘(ssd)和机械硬盘(hdd),选型的核心在于平衡性能、容量与预算。对于大多数现代应用,尤其是数据库和高并发 web 服务,ssd 已成为默认选项;而在需要海量冷数据存储的场景下,hdd 依然具有不可替代的成本优势。
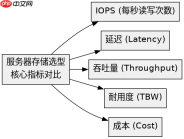
负载特征与介质匹配
不同的业务负载对存储的诉求截然不同。高 IOPS(每秒输入输出操作次数)和低延迟是数据库事务处理的关键指标,这类场景下 NVMe SSD 能提供毫秒级的响应。相反,视频流媒体或大规模数据备份更看重顺序吞吐量和单位容量的价格,HDD 在此类连续读写任务中表现稳定且经济。混合负载则往往采用分层架构,将热数据置于 SSD,冷数据下沉至 HDD。
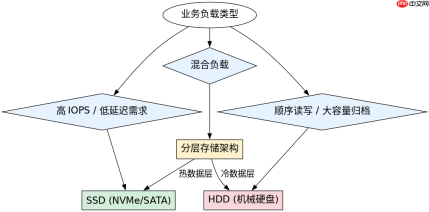
在实际部署中,若预算有限但需提升性能,可考虑 SATA SSD 作为过渡方案。其性能虽不及 NVMe,但远优于 HDD,且接口兼容性好。对于纯归档需求,HDD 的单 TB 成本通常仅为 SSD 的十分之一左右。选型时需明确数据访问频率,避免为低频访问的数据支付高昂的 SSD 溢价。
Python 模拟存储性能评估
为了量化不同存储介质的性能差异,我们可以编写一个简单的 Python 脚本,通过模拟随机读写操作来估算 IOPS 和延迟。以下代码使用 `time` 模块记录操作耗时,并计算吞吐量。

import time
import os
import tempfile

def benchmark_storage(path, num_ops=1000):
    """
    模拟存储性能基准测试
    :param path: 测试文件路径
    :param num_ops: 操作次数
    """
    start_time = time.time()
    for i in range(num_ops):
        # 模拟写入
        with open(path, 'wb') as f:
            f.write(os.urandom(4096))  # 每次写入 4KB
        # 模拟读取
        with open(path, 'rb') as f:
            f.read()
    end_time = time.time()

    duration = end_time - start_time
    iops = num_ops / duration if duration > 0 else 0
    avg_latency = (duration / num_ops) * 1000  # 毫秒

    print(f"路径: {path}")
    print(f"总耗时: {duration:.2f} 秒")
    print(f"模拟 IOPS: {iops:.2f}")
    print(f"平均延迟: {avg_latency:.4f} ms")
    print("-" * 20)

# 执行测试
if __name__ == "__main__":
    # 创建临时目录用于测试
    test_dir = tempfile.gettempdir()
    test_file = os.path.join(test_dir, "perf_test.bin")

    try:
        benchmark_storage(test_file, num_ops=100)
    finally:
        # 清理测试文件
        if os.path.exists(test_file):
            os.remove(test_file)
运行上述脚本时,建议在 SSD 和 HDD 上分别执行,以观察显著的性能差距。SSD 上的 IOPS 通常可达数千甚至数万,而 HDD 受限于物理寻道时间,IOPS 通常在几百以内。该程序仅做简单模拟,实际生产环境应使用 fio 等专业工具进行更全面的测试。预期结果是 SSD 的平均延迟远低于 HDD,且总耗时大幅缩短。
NVMe 协议下的多队列优化
当选用 NVMe SSD 时,必须关注其多队列特性。传统 SATA AHCI 协议设计之初仅支持一个队列,最多 32 个命令。而 NVMe 协议支持多达 64,000 个队列,每个队列可容纳 64,000 个命令。这种设计允许操作系统将不同 CPU 核心的 I/O 请求分发到不同的队列,从而减少锁竞争,提升并行处理能力。
在 Linux 系统中,可通过 `cat /sys/block/nvme0n1/queue/nr_requests` 查看当前队列深度。若应用程序未针对多队列进行优化,可能无法充分发挥 NVMe 的性能。建议在使用高性能 SSD 时,检查数据库或中间件的配置,确保其启用了异步 I/O 和多线程处理机制,以匹配底层硬件的并发能力。
}





