






为什么SQL中多表JOIN时统计信息过旧会导致选错执行计划?
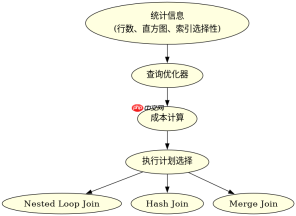
统计信息过旧导致优化器估算的行数与真实数据分布严重偏离,进而使成本计算失效并选择次优的join算法。具体做法是确保在数据发生显著变化后更新统计信息,例如使用analyze命令或自动收集机制,这样优化器能基于准确的基数(cardinality)评估不同join策略的成本,从而选出最优的执行计划。

统计信息如何影响JOIN算法的选择?
统计信息中的直方图和索引选择性直接决定了优化器对驱动表和被驱动表大小的预估。当预估行数偏差较大时,优化器可能错误地选择嵌套循环(Nested Loop)而非哈希连接(Hash Join),或者反之。通过检查统计信息的最新程度和准确性,可以避免这种因基数估计错误导致的性能下降。
-- 假设存在两张表:orders 和 customers
-- 如果 orders 表的统计信息过旧,优化器可能低估其行数

-- 1. 更新统计信息
ANALYZE TABLE orders;
ANALYZE TABLE customers;

-- 2. 执行JOIN查询
SELECT c.name, COUNT(o.id)
FROM customers c
JOIN orders o ON c.id = o.customer_id
GROUP BY c.name;
如何验证统计信息是否准确?
可以通过查看数据库的系统视图或元数据表来确认统计信息的更新时间、行数估算值以及实际行数。对比估算值与实际值的差异,可以判断统计信息是否过时。如果发现显著偏差,应手动触发统计信息更新,以确保优化器做出正确的决策。
-- MySQL: 查看统计信息
SHOW INDEX FROM orders;
-- 或使用 EXPLAIN 查看执行计划中的估算行数
EXPLAIN SELECT c.name, COUNT(o.id)
FROM customers c
JOIN orders o ON c.id = o.customer_id
GROUP BY c.name;


