






如何提取每组的第一条和最后一条记录
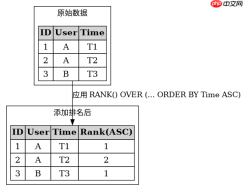
在sql中,利用 group by 直接提取每组的“第一条”或“最后一条”是不准确的,因为聚合函数(如 min()、max())只能返回指定列的最小或最大值,无法直接获取整行数据。要解决这个问题,必须结合窗口函数 rank() 或 dense_rank() 对组内数据进行排序编号,然后在外层查询中筛选出排名为1的记录。

使用 RANK() 实现分组首尾提取
通过 RANK() 函数,我们可以根据指定的排序规则(如时间戳)为每组内的每一行分配一个序号。对于“第一条”,我们按升序排列并取序号为1;对于“最后一条”,我们按降序排列并取序号为1。这种方法能确保即使存在并列值,也能正确识别出符合排序逻辑的首尾记录。
WITH RankedData AS (
    SELECT
        id,
        user_id,
        amount,
        created_at,
        RANK() OVER (PARTITION BY user_id ORDER BY created_at ASC) as rank_asc,
        RANK() OVER (PARTITION BY user_id ORDER BY created_at DESC) as rank_desc
    FROM transactions
)
SELECT
    id,
    user_id,
    amount,
    created_at,
    'first' as record_type
FROM RankedData
WHERE rank_asc = 1
UNION ALL
SELECT
    id,
    user_id,
    amount,
    created_at,
    'last' as record_type
FROM RankedData
WHERE rank_desc = 1;
处理并列情况与性能优化
当组内存在多条完全相同的排序字段值时,RANK() 会生成相同的序号,导致可能返回多行“第一条”或“最后一条”。如果业务要求严格只保留一行,应改用 ROW_NUMBER(),它会在并列时强制分配唯一的序号。此外,为了提升查询性能,建议在 user_id 和 created_at 上建立复合索引,以减少排序操作的开销。



