






为什么SQL中使用GROUP BY会导致临时表与文件排序
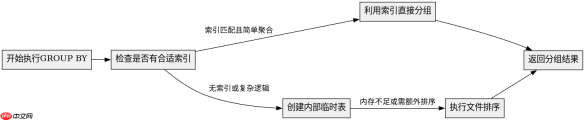
使用group by导致临时表和文件排序是因为mysql在执行分组时,需要先将数据按照分组字段进行排序或哈希聚合。如果无法利用索引完成排序,或者查询中包含了order by、distinct、聚合函数等需要额外处理的操作,mysql就会选择使用临时表来存储中间结果,并在必要时进行文件排序。具体做法是:当group by的字段没有合适的索引支持,或者查询涉及复杂聚合逻辑时,优化器会生成一个内部临时表,并将数据按分组键排序后存入该表,若内存不足则溢出到磁盘文件。
什么情况下GROUP BY会使用索引避免临时表
当GROUP BY的字段顺序与索引的前缀完全匹配,且查询只包含被分组字段的简单聚合(如COUNT、SUM)时,MySQL可以利用索引直接获取分组结果,无需创建临时表。例如,对已建立复合索引的列进行GROUP BY,且无其他过滤条件干扰时,优化器会选择Index Scan而非Filesort。
CREATE TABLE test (id INT, category VARCHAR(10), value DECIMAL(10,2));
CREATE INDEX idx_cat_val ON test(category, value);
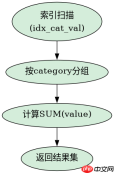
SELECT category, SUM(value) FROM test GROUP BY category;
上述语句中,由于category是索引的第一列,且查询仅对category分组并求和value,MySQL可以直接通过索引扫描完成分组,不会使用临时表。
什么情况下GROUP BY必须使用文件排序
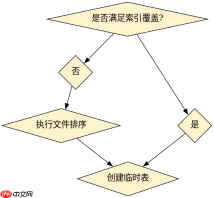
当GROUP BY的字段不在索引前缀中,或者查询中包含ORDER BY子句且其排序方向与分组不一致时,MySQL必须进行文件排序。此外,如果使用了DISTINCT或复杂的表达式作为分组依据,也会强制触发文件排序。此时,即使有索引可用,优化器也可能因成本评估而选择Filesort。
SELECT category, value FROM test ORDER BY value DESC;
SELECT DISTINCT category FROM test;
第一条语句中,虽然category有索引,但ORDER BY value要求按非索引列降序排列,因此必须使用文件排序。第二条语句中,DISTINCT隐式执行了去重操作,等同于GROUP BY,若未指定排序则可能触发临时表和文件排序。
基于程序中某个输入、条件或结果的具体问题
在程序中使用GROUP BY时,若传入的分组字段为NULL值,MySQL会将所有NULL视为同一组进行聚合。这意味着,即使多个记录的分组字段为空,它们仍会被合并为一行输出。这种行为可能导致业务逻辑误判,特别是在统计“未分类”数据时,需显式处理NULL值以避免歧义。


