






where用于在分组前过滤行,having用于在分组后过滤组。处理聚合数据时,先通过where剔除无关行以减轻计算负担,再用having筛选满足条件的分组结果。

WHERE子句如何过滤原始数据
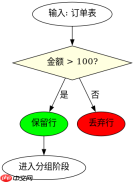
WHERE子句直接作用于FROM子句指定的表或视图,在GROUP BY执行之前对每一行数据进行判断。它不能使用聚合函数,因为此时数据尚未分组统计。例如,要查找订单金额大于100的记录,应使用WHERE amount > 100。这能显著减少后续分组和聚合操作的数据量。
SELECT customer_id, SUM(amount) as total
FROM orders
WHERE amount > 100
GROUP BY customer_id;
上述查询首先过滤掉所有小于等于100的订单行,然后对剩余的行按客户ID分组并求和。如果错误地将条件放在HAVING中,数据库仍需对所有行进行分组计算,效率较低。
HAVING子句如何过滤分组结果
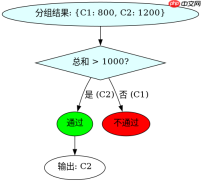
HAVING子句专门用于过滤GROUP BY产生的分组。它可以在条件中使用聚合函数,如SUM、COUNT、AVG等。例如,要找出总订单金额超过1000的客户,必须使用HAVING SUM(amount) > 1000。这是因为总金额是在分组过程中计算出来的,WHERE无法访问这些中间结果。
SELECT customer_id, SUM(amount) as total
FROM orders
GROUP BY customer_id
HAVING SUM(amount) > 1000;
该查询先按客户ID将所有订单分组,计算每个客户的总金额,然后筛选出总金额大于1000的组。这是WHERE无法完成的任务,因为它在分组前执行,不知道每组的总和是多少。
同时使用WHERE与HAVING的具体场景
当需要结合行级过滤和组级过滤时,WHERE和HAVING可以共存。WHERE先过滤原始行,HAVING再过滤分组结果。例如,查找2023年下单且总金额超过500的客户。WHERE过滤年份,HAVING过滤总金额。这种组合既提高了效率,又满足了复杂的业务逻辑需求。


