






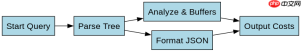
在postgresql 16中,通过explain分析join成本的核心方法是使用 explain (analyze, buffers, format json) 组合命令。该命令不仅展示优化器预估的成本(如nested loop、merge join或hash join的代价),还能通过 analyze 参数获取实际执行时间,并通过 buffers 参数揭示i/o瓶颈。结合json格式输出,可以精确提取每个节点的具体数值,从而定位性能问题。
如何识别并对比不同JOIN算法的预估成本?
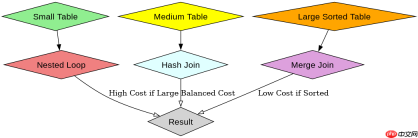
要识别不同的JOIN算法及其成本,需关注 EXPLAIN 输出中的 Node Type 和 Cost 字段。PostgreSQL优化器会根据统计信息选择成本最低的算法,常见的有Nested Loop、Hash Join和Merge Join。Nested Loop适合小表驱动大表,其成本随行数呈二次方增长;Hash Join适合中等大小表的等值连接,成本主要在于构建哈希表;Merge Join则要求输入已排序,成本较低但准备成本高。通过比较这些节点的 Total Cost,可以判断优化器的决策依据。
EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT) SELECT * FROM orders o JOIN customers c ON o.customer_id = c.id WHERE c.region = 'US';
运行上述查询后,观察输出中的 Hash Join 节点。若 Actual Rows 与 Est. Rows 差异巨大,说明统计信息过时。此时可手动更新统计信息:ANALYZE orders; ANALYZE customers;。若发现 Seq Scan 成本过高,考虑添加索引:CREATE INDEX idx_orders_customer_id ON orders(customer_id);。再次运行EXPLAIN,对比成本变化。
如何利用BUFFERS参数诊断JOIN过程中的I/O开销?
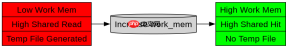
BUFFERS 参数提供详细的缓冲层统计,包括Shared Hit/Read/Dirtied/Written和Temp Hit/Read。Shared Hit表示从共享缓冲区命中,速度最快;Shared Read表示需要从磁盘读取,是性能瓶颈的主要来源。在JOIN操作中,如果Hash Join的 Shared Read 很高,说明哈希表无法完全放入内存,导致频繁磁盘I/O。此时应增加 work_mem 配置,使哈希表能在内存中构建完成。

SET work_mem = '64MB'; EXPLAIN (ANALYZE, BUFFERS) SELECT * FROM large_table a JOIN large_table b ON a.id = b.id;
执行上述代码,观察 Hash Join 节点的 Buffers: shared hit=... read=...。若 read 值显著降低,说明增加 work_mem 有效。注意,work_mem 是每个排序或哈希操作独立分配的,并发高时需谨慎设置,避免内存溢出。同时,检查 Temp File 是否生成,若有,说明临时文件写入磁盘,进一步证实内存不足。
当JOIN结果集为空时,EXPLAIN会显示什么成本特征?
当JOIN条件导致结果集为空时,优化器可能提前终止执行,表现为 Actual Rows 为0。此时,Total Cost 可能远低于预期,因为优化器利用了过滤条件或索引快速返回空结果。例如,若JOIN条件涉及不存在的值,且存在唯一索引,优化器可能直接扫描索引并立即返回空。这种情况下,成本分析的重点不再是JOIN算法本身,而是索引查找的效率。通过 EXPLAIN 可见 Index Scan 或 Bitmap Index Scan 的低成本特性。


