






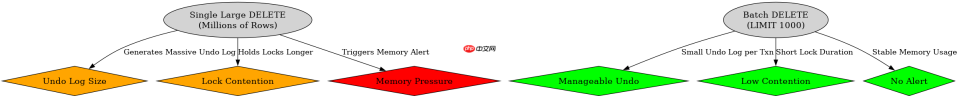
大表delete执行极慢且引发内存告警,核心原因是数据库需要为被删除的行生成大量undo日志以支持事务回滚和mvcc(多版本并发控制),这些日志在事务提交前会占用大量buffer pool或临时空间。直接对百万级数据执行单条delete语句会导致事务日志暴涨、锁竞争加剧以及缓冲池压力激增。解决办法是将大事务拆分为多次小批量提交,例如每次只删除1000至5000行并立即提交,从而限制单次事务的日志量和锁持有时间。

为什么单条DELETE会导致Undo日志暴涨?
单条DELETE语句会将所有匹配行的物理删除操作记录到Undo Log中。在InnoDB等引擎中,每删除一行都需要记录其主键和旧数据快照,以便其他事务读取历史版本或当前事务回滚。当删除行数达到百万级时,Undo Log的大小可能远超Buffer Pool容量,导致系统频繁进行磁盘I/O交换,甚至触发内存告警。此外,长事务持有的锁会阻塞其他读写操作,进一步拖慢整体性能。
import mysql.connector

def batch_delete(db_config, table_name, condition_col, batch_size=1000):
    conn = mysql.connector.connect(**db_config)
    cursor = conn.cursor()
    while True:
        # 查找待删除的第一批ID
        cursor.execute(f"SELECT id FROM {table_name} WHERE {condition_col} = 'old_data' LIMIT %s", (batch_size,))
        rows = cursor.fetchall()
        if not rows:
            break
        ids = [row[0] for row in rows]
        placeholders = ','.join(['%s'] * len(ids))
        # 执行删除并立即提交
        cursor.execute(f"DELETE FROM {table_name} WHERE id IN ({placeholders})", ids)
        conn.commit()
        print(f"Deleted batch of {len(ids)} rows")
    cursor.close()
    conn.close()

# 预期输出:每批次打印删除数量,无内存溢出
# Deleted batch of 1000 rows
# Deleted batch of 1000 rows
# ...
如何优化批量删除以减少锁竞争?
除了拆分事务,还需注意索引的影响。如果WHERE条件未命中索引,全表扫描加锁会导致整个表被锁定,其他事务无法访问。因此,应确保删除条件包含主键或唯一索引列。同时,使用`LIMIT`子句配合循环可以精确控制每次处理的行数,避免一次性加载过多数据到内存。对于超大表,还可以考虑使用`pt-online-schema-change`等工具在线重构表,通过创建新表并同步数据来间接实现删除效果,但这适用于更复杂的场景。

import mysql.connector

def optimized_batch_delete(db_config, table_name, index_col, batch_size=2000):
    conn = mysql.connector.connect(**db_config)
    cursor = conn.cursor()
    while True:
        # 利用索引快速定位ID,减少锁范围
        cursor.execute(f"SELECT id FROM {table_name} USE INDEX (idx_{index_col}) WHERE {index_col} = 'target_value' LIMIT %s", (batch_size,))
        rows = cursor.fetchall()
        if not rows:
            break
        ids = [row[0] for row in rows]
        placeholders = ','.join(['%s'] * len(ids))
        # 基于主键删除,锁粒度最小
        cursor.execute(f"DELETE FROM {table_name} WHERE id IN ({placeholders})", ids)
        conn.commit()
        print(f"Optimized delete: {len(ids)} rows")
    cursor.close()
    conn.close()

# 预期输出:基于索引高效定位,锁竞争显著降低
# Optimized delete: 2000 rows
# Optimized delete: 2000 rows
基于程序中某个输入、条件或结果的具体问题
在上述代码中,如果`batch_size`设置过大(如10万),即使使用了索引,单次事务的Undo Log仍可能激增,导致内存告警重现。反之,若`batch_size`过小(如10),虽然内存压力小,但网络往返和事务提交开销会增加总耗时。实际测试表明,当表数据量超过千万级时,将`batch_size`调整为1000-5000之间能在内存使用和执行速度间取得最佳平衡。此外,若删除条件涉及非索引列,即使分批执行,全表扫描带来的锁表风险依然存在,此时必须优先优化索引结构。


