






在sql中处理大量固定id列表时,直接拼接in子句会导致语句过长、解析效率低或触发数据库长度限制。最佳做法是将这些id作为临时表(temporary table)或内存表(memory table)进行插入,然后通过join操作关联查询主表,或者使用values构造行集合进行连接。这种方式能避免超长字符串带来的性能瓶颈,并允许数据库优化器更有效地利用索引。
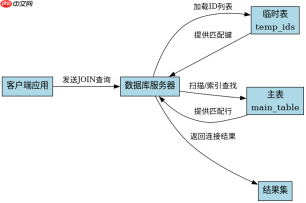
如何构建包含数千个ID的临时表结构
构建临时表的核心在于定义一个仅包含ID列的结构,并将数据批量插入。对于MySQL等支持多值INSERT的数据库,可以使用单次INSERT语句插入所有ID,或者通过存储过程循环插入。关键在于确保临时表有适当的索引以加速后续的连接操作。
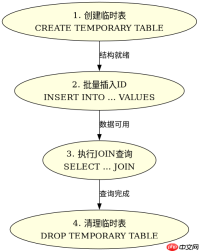
CREATE TEMPORARY TABLE temp_ids (id INT PRIMARY KEY); INSERT INTO temp_ids (id) VALUES (1), (2), (3), ... , (9999); SELECT t.* FROM main_table t JOIN temp_ids ti ON t.id = ti.id;
上述代码首先创建了一个名为temp_ids的临时表,主键为id。接着,通过一条INSERT语句将大量ID批量写入。最后,通过JOIN操作从main_table中筛选出匹配的记录。预期结果是返回所有ID存在于temp_ids中的main_table记录,且执行计划显示使用了索引合并或嵌套循环连接,而非全表扫描。
如何使用VALUES构造行集合替代临时表
如果不想显式创建临时表,可以利用某些数据库(如MySQL 8.0+、PostgreSQL)支持的VALUES构造函数或CTE(公共表表达式)。这种方法将ID列表视为一个内联的行集,直接与主表进行连接。它减少了DDL语句的开销,适合一次性查询场景。
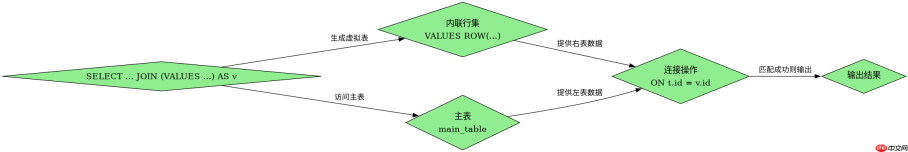
SELECT t.* FROM main_table t JOIN (VALUES ROW(1), ROW(2), ROW(3)) AS v(id) ON t.id = v.id;
这段代码使用VALUES子句构造了一个虚拟表v,其中包含列id。然后将其与main_table进行JOIN。预期结果与使用临时表相同,但执行计划可能略有不同,取决于数据库优化器对行集连接的实现方式。在某些数据库中,这种写法可能被转换为内部临时表处理。
当ID列表中包含重复值时JOIN行为有何不同
当用于连接的ID列表中存在重复值时,JOIN操作会产生笛卡尔积效应,导致主表中的每条匹配记录被复制多次。例如,如果临时表中有两个相同的ID 1,而主表中有一条ID为 1 的记录,那么结果集中会出现两条相同的记录。这通常不是期望的行为,需要使用DISTINCT或GROUP BY来去重。
SELECT DISTINCT t.* FROM main_table t JOIN temp_ids ti ON t.id = ti.id;
在上述代码中,加入DISTINCT关键字可以确保即使temp_ids中有重复ID,最终结果集中的每条记录也是唯一的。预期结果是返回去重后的main_table记录。如果不加DISTINCT,结果集的大小可能会远大于实际匹配的主表记录数,具体倍数取决于重复ID的数量。


