






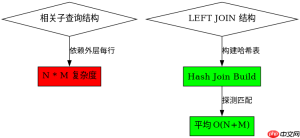
在sql中解决相关子查询执行计划走nested loops过慢的问题,核心思路是将其转换为连接(join)操作或使用窗口函数,从而让优化器能够选择更高效的哈希连接或排序合并策略。具体做法是将原本在where子句中依赖外层表每行进行扫描的子查询,改写为基于主键或唯一索引的left join,或者利用分析函数消除重复计算。这样做可以将嵌套循环的o(n*m)复杂度降低,显著减少i/o开销和cpu等待时间。

如何将相关子查询改写为JOIN
将相关子查询替换为LEFT JOIN可以直接改变执行计划的路径,使数据库引擎能够利用索引进行快速查找而非全表扫描。假设我们有一个订单表orders和一个客户表customers,原查询通过相关子查询获取每个订单对应的客户名称。改写时,只需将子查询条件移至ON子句,并选择适当的连接类型。这种改写在大多数关系型数据库中都能有效触发Hash Join或Merge Join,避免Nested Loops带来的逐行匹配延迟。
SELECT o.order_id, c.customer_name
FROM orders o
LEFT JOIN customers c ON o.customer_id = c.id
WHERE o.status = 'active';
上述代码展示了标准的改写模式。输入为orders表和customers表,实际调用是通过ON子句建立关联。预期结果是返回所有活跃订单及其对应的客户名。若customers表的id字段有索引,执行计划通常会显示为Nested Loops Inner Join,但这比相关子查询的Nested Loops Semi Join更高效,因为内层表只需一次索引查找即可匹配多行,且避免了子查询的重入开销。如果数据量极大,优化器可能会自动升级为Hash Join,这取决于统计信息的准确性。
何时使用窗口函数替代去重逻辑
当相关子查询的目的是为了获取每组中的最大值、排名或首条记录时,使用窗口函数(Window Functions)是更优的选择。这类场景下,相关子查询往往需要对每一行重新执行聚合或排序操作,导致严重的性能瓶颈。通过引入OVER()子句,可以在单次扫描中完成分组计算,彻底消除嵌套循环的执行路径。这种方法特别适用于需要保留原始行结构同时附加聚合信息的查询需求。

SELECT order_id, customer_id, amount,
       ROW_NUMBER() OVER(PARTITION BY customer_id ORDER BY amount DESC) as rn
FROM orders;
-- 后续在外层过滤 rn = 1 即可得到每个客户的最高金额订单
这段代码演示了如何用ROW_NUMBER()替代“获取每个客户最高金额订单”的相关子查询。输入是orders表,结果包含每行的排名信息。在实际运行中,该查询会先进行Partition By分组,然后在组内进行排序。虽然排序本身有开销,但它是一次性的全局操作,远优于对每个客户ID重复执行子查询。执行计划中通常会出现Sort和Window Aggregation算子,完全摒弃了Nested Loops。需要注意的是,窗口函数要求数据库支持SQL:2003标准,主流如MySQL 8.0+、PostgreSQL、Oracle等均原生支持。
为什么某些情况下改写后依然走Nested Loops
即使将相关子查询改写为JOIN或使用窗口函数,执行计划仍可能选择Nested Loops,这通常是因为统计信息不准确或数据分布极度倾斜。例如,当外层表行数极少而内层表行数极多时,优化器认为Nested Loops的随机I/O成本低于Hash Join的构建成本。此外,如果连接列缺乏合适的索引,或者存在复杂的过滤条件导致基数估计错误,优化器也可能保守地选择Nested Loops。此时,强制提示(Hint)或更新统计信息是必要的干预手段。


