






clickhouse sql的窗口函数执行性能更优,核心原因在于其基于列式存储和向量化执行引擎,能够直接利用聚合树(aggregation tree)在内存中完成数据的流式计算,避免了传统关系型数据库常见的全表排序或大规模数据洗牌(shuffle)开销。具体做法是:使用支持window function的sql语法进行查询,clickhouse会在解析阶段将窗口操作转化为高效的聚合算子,并在mergetree引擎的数据分片上并行处理。这样做得到的结果是,即使面对海量数据,也能通过减少i/o和内存交换显著提升查询速度。若涉及复杂分区键或大宽表,需确保分区策略合理以发挥最大效能。
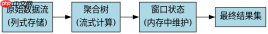
ClickHouse如何处理窗口函数的底层逻辑
ClickHouse处理窗口函数的底层逻辑主要依赖于其独特的聚合树结构,而非传统的排序后扫描。当执行包含窗口函数的查询时,系统会将窗口定义转换为内部的聚合状态,并在数据读取过程中动态维护这些状态。这种机制使得数据无需被完整加载到内存中进行排序,而是边读边算。例如,对于RANK()或ROW_NUMBER()等函数,ClickHouse会利用有序的数据片段直接生成排名,从而大幅降低CPU和内存的使用率。这一过程的关键在于理解ClickHouse如何将SQL语义映射到底层的C++聚合实现上。
SELECT
    id,
    value,
    ROW_NUMBER() OVER (PARTITION BY id ORDER BY value) as rn
FROM
    my_table
WHERE
    date >= '2023-01-01'
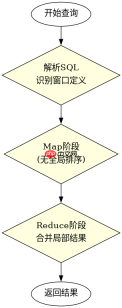
上述代码展示了基本的窗口函数用法。预期结果中,rn列将为每个id分组内的记录按value升序分配唯一序号。由于ClickHouse的列式存储特性,id和value列可以独立高效地读取和比较,无需回表查询。在实际运行中,如果数据量较大,建议结合date列进行分区过滤,以减少扫描范围。该查询的执行计划通常会显示为“ReadFromMergeTree”后接“Window”,表明数据在读取阶段即开始构建窗口状态。
为什么ClickHouse的窗口函数比传统数据库快
ClickHouse的窗口函数之所以比传统数据库快,主要是因为其消除了中间结果的持久化和网络传输开销。在传统数据库中,窗口函数往往需要先将数据排序并写入临时表,然后再进行二次扫描以计算窗口值。而ClickHouse利用其分布式架构,将窗口计算下推到各个节点本地执行,仅合并最终结果。这种“计算下推”模式极大地减少了数据移动。此外,ClickHouse的向量化执行引擎允许一次性处理多行数据,进一步提升了吞吐量。对于高并发场景,这种设计能有效避免锁竞争和上下文切换带来的延迟。

SELECT
    user_id,
    event_time,
    SUM(amount) OVER (PARTITION BY user_id ORDER BY event_time ROWS BETWEEN 2 PRECEDING AND CURRENT ROW) as rolling_sum
FROM
    events
LIMIT 1000
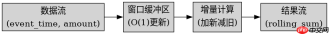
这段代码演示了滚动求和的窗口函数应用。预期结果中,rolling_sum将显示每个用户最近三次事件的金额总和。与传统数据库相比,ClickHouse在处理此类滑动窗口时,无需为每一行重新计算整个窗口的聚合值,而是利用增量更新机制维护窗口状态。这意味着随着数据流的推进,只需添加新进入窗口的值并移除超出窗口的值,计算复杂度从O(N)降低到接近O(1)。这种优化在处理时间序列数据时尤为明显,能够显著缩短查询响应时间。
窗口函数在ClickHouse中的内存占用情况如何
窗口函数在ClickHouse中的内存占用情况相对可控,主要取决于窗口的大小和数据类型的复杂度。由于ClickHouse采用列式存储,窗口计算所需的中间状态通常只保留当前窗口内的必要字段,而非整行数据。这使得即使在处理大表时,内存峰值也不会过高。然而,如果窗口定义涉及复杂的自定义聚合函数或多层嵌套窗口,内存消耗可能会增加。因此,合理设置max_memory_usage参数和优化窗口大小是关键。此外,ClickHouse的内存管理模块会自动回收不再需要的聚合状态,防止内存泄漏。



