






在sql中利用多列子查询进行批量匹配,核心做法是将目标表的多列组合成行值构造器(row value constructor),并与子查询返回的多列结果集进行相等比较。具体而言,使用 (col1, col2) 语法包裹待匹配的列,并通过 in 或 not in 操作符与子查询连接。这样做可以一次性基于多个字段的组合唯一性进行过滤,避免编写冗长的 and 条件链,同时能充分利用数据库对复合索引的优化能力。
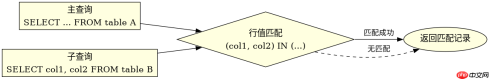
如何构建多列匹配的子查询结构
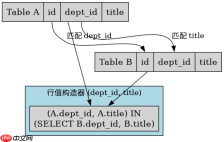
构建多列匹配的关键在于正确使用行值构造器的语法。大多数现代关系型数据库(如 MySQL、PostgreSQL、Oracle)支持将多个列视为一个元组进行比较。例如,要查找在 employees 表中存在相同 department_id 和 job_title 组合的记录,可以将这两个字段括在括号内,直接对比子查询的结果。这种写法比分别对每个字段做 IN 子查询并用 AND 连接更简洁,且语义上更接近“整行匹配”的概念。
SELECT e1.id, e1.name
FROM employees e1
WHERE (e1.department_id, e1.job_title) IN (
    SELECT department_id, job_title
    FROM employees e2
    WHERE e2.hire_date > '2023-01-01'
);
上述代码展示了基本结构:外层查询选取 e1 表的记录,其 department_id 和 job_title 的组合必须存在于内层子查询返回的结果集中。内层子查询筛选出2023年后入职的员工及其职位部门信息。如果子查询返回空集,整个 IN 条件为假,不会报错。注意,若子查询中包含 NULL 值,IN 的行为可能因数据库实现而异,通常建议确保子查询结果不含 NULL 或使用 EXISTS 替代。
如何处理多列匹配中的空值与性能问题
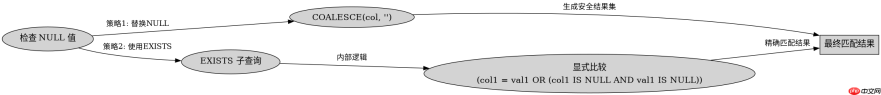
多列匹配时,NULL 值的处理是一个常见陷阱。在标准 SQL 中,NULL = NULL 的结果是未知(Unknown),而非真。因此,如果参与匹配的列允许 NULL,直接使用 (col1, col2) IN (...) 可能导致预期之外的漏匹配。为解决此问题,可以在子查询中使用 COALESCE 函数将 NULL 替换为默认值,或者改用 EXISTS 子句配合显式的 IS NOT DISTINCT FROM 逻辑(如果数据库支持)。此外,性能方面,多列匹配依赖于复合索引。如果 (department_id, job_title) 上有联合索引,数据库可以快速定位;否则可能退化为全表扫描或嵌套循环连接。
-- 使用 EXISTS 避免 NULL 匹配问题
SELECT e1.id, e1.name
FROM employees e1
WHERE EXISTS (
    SELECT 1
    FROM employees e2
    WHERE e2.hire_date > '2023-01-01'
      AND e2.department_id = e1.department_id
      AND (e2.job_title = e1.job_title OR (e2.job_title IS NULL AND e1.job_title IS NULL))
);
这段代码展示了使用 EXISTS 的替代方案。它逐行检查是否存在满足条件的记录,通过显式处理 job_title 的 NULL 情况,确保逻辑正确。虽然写法稍长,但在处理含 NULL 的多列匹配时更可靠。实际应用中,应根据数据是否含 NULL 以及数据库版本选择合适的方式。若确定无 NULL,优先使用 IN 的行值构造器写法,因其更简洁且优化器通常能更好地处理。
当子查询返回多行时主查询如何接收结果
当子查询返回多行多列时,主查询的 IN 子句会将这些行视为一个集合。只要主查询当前行的多列组合与该集合中的任意一行完全匹配,条件即成立。这意味着即使子查询返回成千上万条记录,主查询也只需判断是否存在匹配项,而非逐一关联。这种机制非常适合批量更新或删除场景,例如从临时表中匹配大量配置项。需要注意的是,子查询不应返回重复行,虽然 IN 能处理重复,但去重后的结果集更小,执行效率更高。数据库优化器通常会自动对子查询结果进行去重或哈希聚合,以提升性能。
,


