






在sql中结合distinct与sum计算非重复金额,核心做法是先通过子查询或cte对数据进行去重处理,再对外层结果进行聚合。具体而言,使用`select distinct column from table`获取唯一记录集,然后在外层包裹`sum()`函数即可得到不重复值的总和。这种方法适用于需要排除完全相同的多行记录(如重复的交易流水)后求和的场景,确保每个唯一的业务实体只被计入一次总金额。

DISTINCT作用于单列时的去重逻辑
当DISTINCT关键字应用于单个列时,数据库会筛选出该列中所有唯一的值。如果直接对这一列使用SUM(),实际上是对这些唯一值进行求和。这在某些特定场景下是有用的,例如计算不同价格等级的商品总定价潜力,但通常我们更关心的是基于多列组合的唯一性。下面展示一个基础示例,假设有一个prices表,包含item_id和price两列,其中存在重复的price值。
CREATE TABLE prices (
    item_id INT,
    price DECIMAL(10, 2)
);

INSERT INTO prices VALUES (1, 10.00);
INSERT INTO prices VALUES (2, 20.00);
INSERT INTO prices VALUES (3, 10.00); -- 重复的价格
INSERT INTO prices VALUES (4, 30.00);

-- 查询唯一价格的总和
SELECT SUM(price) AS unique_price_sum
FROM (
    SELECT DISTINCT price
    FROM prices
) AS distinct_prices;
预期结果:
unique_price_sum: 60.00
解释:唯一的价格为10.00, 20.00, 30.00,总和为60.00。注意,这里不是对所有原始行的price求和(那是70.00),而是对去重后的值求和。
DISTINCT作用于多列组合的去重逻辑
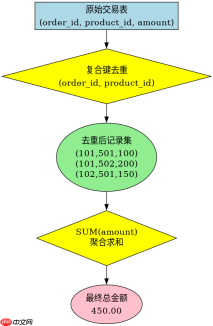
在实际业务中,往往需要根据多个字段组合来判断“重复”。例如,一笔交易可能由order_id、product_id和amount共同定义。如果同一订单中的同一产品有多条记录(可能是数据冗余),我们需要先根据这三者去重,再对amount求和。DISTINCT在多列上的作用是筛选出整行记录唯一的集合。以下代码演示了如何基于order_id和product_id去重后,计算amount的总和。
CREATE TABLE transactions (
    order_id INT,
    product_id INT,
    amount DECIMAL(10, 2)
);

INSERT INTO transactions VALUES (101, 501, 100.00);
INSERT INTO transactions VALUES (101, 501, 100.00); -- 完全重复的行
INSERT INTO transactions VALUES (101, 502, 200.00);
INSERT INTO transactions VALUES (102, 501, 150.00);

-- 基于order_id和product_id去重后,求amount总和
SELECT SUM(amount) AS total_amount
FROM (
    SELECT DISTINCT order_id, product_id, amount
    FROM transactions
) AS distinct_transactions;
预期结果:
total_amount: 450.00
解释:去重后的记录为(101,501,100), (101,502,200), (102,501,150)。总和为100+200+150=450。如果不加DISTINCT,总和将是100+100+200+150=550。

处理部分列重复且需保留其他列信息的场景
有时需求更复杂:我们需要根据某些列去重,但求和的列并不在去重键中,或者去重后需要保留其他非聚合列的信息。虽然DISTINCT本身不能直接与非聚合列混用(除非它们也在DISTINCT列表中),但可以通过GROUP BY配合DISTINCT的子查询来实现更灵活的控制。例如,按category分组,在每个类别内,对transaction_id唯一的amount求和。这能确保即使同一类别下有多个相同金额的记录,只要它们的transaction_id不同,就会被分别计算;但如果transaction_id也相同(即完全重复行),则只算一次。不过,若目标是“非重复金额”,通常指金额值本身的去重。若需按组内金额去重,可使用窗口函数或更复杂的子查询。此处展示一个常见变体:按user_id分组,计算每个用户唯一消费金额的总和(即如果一个用户多次购买同一件商品且金额相同,只算一次该金额)。
CREATE TABLE purchases (
    user_id INT,
    product_id INT,
    amount DECIMAL(10, 2)
);

INSERT INTO purchases VALUES (1, 101, 50.00);
INSERT INTO purchases VALUES (1, 102, 50.00); -- 不同商品,相同金额
INSERT INTO purchases VALUES (1, 103, 50.00); -- 不同商品,相同金额
INSERT INTO purchases VALUES (2, 101, 100.00);

-- 按user_id分组,计算每个用户唯一amount的总和
SELECT
    user_id,
    SUM(unique_amount) AS sum_of_unique_amounts
FROM (
    SELECT
        user_id,
        DISTINCT amount -- 注意:标准SQL中不能在SELECT列表中使用DISTINCT而不用于整个SELECT
        -- 正确做法是使用子查询先获取该用户下的唯一金额
) AS sub;

-- 修正后的正确写法:
SELECT
    p.user_id,
    SUM(u.unique_amt) AS sum_of_unique_amounts
FROM (
    SELECT DISTINCT user_id, amount
    FROM purchases
) AS u
JOIN purchases p ON u.user_id = p.user_id
GROUP BY p.user_id;

-- 更简洁的写法,直接对每个用户的唯一金额求和:
SELECT
    user_id,
    SUM(amount) AS total_unique_amount
FROM (
    SELECT DISTINCT user_id, amount
    FROM purchases
) AS distinct_user_amounts
GROUP BY user_id;
预期结果:
user_id: 1, sum_of_unique_amounts: 50.00
user_id: 2, sum_of_unique_amounts: 100.00
解释:对于user_id 1,其出现的金额有50.00, 50.00, 50.00。去重后唯一金额为50.00,总和为50.00。对于user_id 2,唯一金额为100.00,总和为100.00。这种写法确保了在每个用户维度上,相同的金额值只被累加一次。


