






在sql中安全地跨数据库实例进行视图与物理表join,核心做法是建立外部数据源连接(如使用`server`和`linked server`或`fdw`),并通过完全限定的四部分名称(服务器.数据库.架构.表)来引用远程对象。具体实现时,需确保本地会话能正确解析远程元数据,并在查询中利用索引下推或过滤条件减少网络传输开销。若涉及权限隔离,应配置独立的登录映射以限制访问范围。
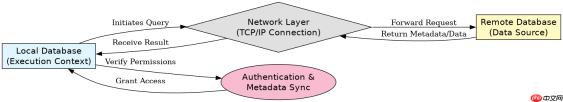
如何配置并验证跨库连接的元数据可见性
要确保跨库JOIN可行,首要步骤是建立稳定的外部数据源连接并验证元数据同步。通过创建链接服务器或外部数据源,系统能够识别远程数据库中的表和视图结构。关键在于检查本地用户是否拥有对远程对象的读取权限,以及连接字符串中的认证方式是否正确配置。一旦连接建立,可以通过查询系统目录视图来确认远程对象是否已注册到当前会话的上下文中,这是执行后续JOIN操作的前提。
-- SQL Server 示例:创建链接服务器
EXEC sp_addlinkedserver
    @server = 'RemoteDB',
    @srvproduct = 'SQL Server',
    @provider = 'SQLNCLI',
    @datasrc = 'remote_server_ip';

-- 验证连接及元数据
SELECT * FROM RemoteDB.TargetDB.dbo.SysTables;
上述代码展示了如何在SQL Server环境中添加一个名为`RemoteDB`的链接服务器。执行后,可以通过四部分命名法访问远程表。验证阶段的关键是查询远程系统的系统表,确保本地客户端能获取到远程表的列定义和类型信息。如果元数据不可见,JOIN操作将因找不到对象而失败。此外,需注意网络连接延迟对元数据加载的影响,建议在非高峰时段进行首次同步。

跨库JOIN时的性能优化与数据过滤策略
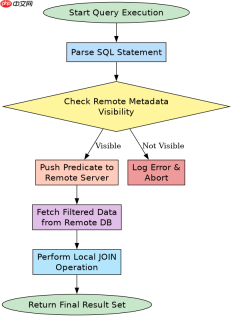
跨库JOIN的性能瓶颈通常在于网络I/O和数据传输量。为了优化性能,应尽量将过滤条件推送到远程服务器执行,即利用“谓词下推”技术。通过在远程端先进行`WHERE`筛选,再返回少量结果集进行本地JOIN,可以显著降低带宽消耗。同时,避免在远程视图上直接进行复杂的聚合操作,除非远程视图本身已预计算了相关指标。对于大表JOIN,建议先在远程端建立临时表或物化视图,再将其拉取至本地进行关联。
-- 优化后的跨库JOIN查询
SELECT l.col1, r.col2
FROM LocalTable l
INNER JOIN RemoteDB.TargetDB.dbo.RemoteTable r
    ON l.id = r.local_id
WHERE r.update_time > '2023-01-01'; -- 谓词下推示例
在上面的查询中,`WHERE`子句被设计为优先在远程端执行,以减少返回的数据行数。这种策略要求远程表上有适当的索引支持`update_time`字段。如果远程视图包含复杂逻辑,可能需要评估其执行计划,确保远程优化器能有效处理过滤条件。此外,定期检查统计信息的更新状态,有助于查询优化器选择更高效的JOIN算法,如哈希连接或嵌套循环。
当远程表存在主键冲突时JOIN结果如何处理
在跨库JOIN场景中,如果远程表的主键在本地表中存在重复值,或者远程表自身数据不一致导致多行匹配,JOIN结果会产生笛卡尔积效应,即一行本地记录匹配多行远程记录。这种情况下,结果集的规模会迅速膨胀,可能导致内存溢出或查询超时。解决此问题的方法是明确指定JOIN类型,并在应用层或SQL层对结果进行去重或聚合处理。例如,使用`DISTINCT`或`GROUP BY`来合并重复的关联数据,或者在远程端预先清洗数据,确保主键的唯一性。







