






在sql中实现按行号row number批量更新排序列,核心思路是利用窗口函数 row_number() 生成临时序号,并通过子查询或cte(公用表表达式)将结果关联回原表进行更新。具体做法是:先构建一个包含目标行和对应序号的派生表,然后基于该派生表的唯一标识符(如主键)执行 update 语句,将原表的排序字段赋值为计算出的序号。这样做可以确保在复杂的排序逻辑下,每一行都能获得准确且唯一的顺序值。

如何为特定分组内的数据生成连续的行号?
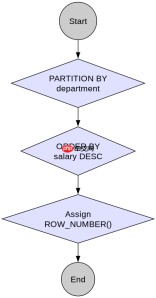
当需要针对每个分组(例如部门、类别)独立生成从1开始的连续行号时,必须在 ROW_NUMBER() 函数中加入 PARTITION BY 子句。这会将数据集划分为多个独立的分区,每个分区内重新计算行号。结合 ORDER BY 指定组内排序依据,即可得到符合业务逻辑的局部排序结果。
WITH RankedData AS (
    SELECT
        id,
        department,
        salary,
        ROW_NUMBER() OVER (PARTITION BY department ORDER BY salary DESC) as rn
    FROM employees
)
SELECT * FROM RankedData;
上述代码展示了如何按部门分组并按薪资降序排列。对于输入数据中的每个部门,rn 列都会从1开始递增。如果两个员工薪资相同,数据库会根据内部稳定性或次要排序条件决定先后,但通常建议添加唯一键作为第二排序条件以保证确定性。
如何处理排序列冲突并保证更新的原子性?
在执行批量更新时,必须确保源数据的排序结果是确定性的,否则不同执行计划可能导致行号分配不一致。通过在 ORDER BY 中包含主键或唯一索引列,可以避免因数据相等导致的随机排序。此外,使用CTE包裹整个选择逻辑并在同一事务中执行更新,可以保证读取到的行号与写入时的状态一致,防止并发修改导致的数据错乱。

WITH CTE AS (
    SELECT
        id,
        ROW_NUMBER() OVER (ORDER BY created_at, id) as new_sort_order
    FROM tasks
)
UPDATE t
SET sort_order = c.new_sort_order
FROM tasks t
JOIN CTE c ON t.id = c.id;
这段代码演示了如何在没有分组的情况下,全局生成行号并更新 sort_order 字段。关键在于 JOIN 操作确保了只有匹配的主键才会被更新。若 created_at 存在重复值,id 作为第二排序键保证了每次运行结果完全一致。此方法适用于大多数支持CTE和窗口函数的关系型数据库,如PostgreSQL、SQL Server和Oracle。
当排序列为NULL时,更新后的初始值是多少?
在更新过程中,如果原表中的 sort_order 字段初始为 NULL,经过上述批量更新后,所有行的 sort_order 将被替换为从1开始的整数序列。不存在保留 NULL 的情况,因为 ROW_NUMBER() 始终返回非空整数。若需保留某些特殊行的 NULL 状态,需在CTE中使用 CASE WHEN 进行过滤,或在更新语句中添加 WHERE 条件排除特定行。


