






在sql中结合cte与窗口函数提升复杂查询可读性的核心做法是:先用cte将数据清洗、过滤和基础聚合等前置步骤独立出来,形成清晰的中间结果集;再在主查询中对这些中间结果应用窗口函数进行排名、累计或分布计算。这样做不仅避免了深层嵌套的子查询,还让每一步的逻辑意图变得一目了然。例如,处理用户行为日志时,可以先通过cte筛选出有效会话,随后在主查询中使用`row_number()`或`rank()`按时间排序,从而轻松提取每个用户的最新记录或计算连续登录天数。

如何设计CTE结构以隔离数据预处理逻辑
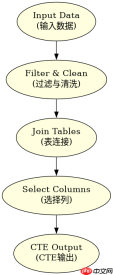
设计CTE结构的关键在于将“原始数据”转化为“业务就绪数据”。具体做法是在第一个CTE块中完成数据的过滤(如去除空值)、类型转换以及必要的字段重命名。这样做的结果是主查询不再需要处理脏数据,只需关注业务逻辑。若存在多表关联,建议在CTE中提前完成Join操作,并只保留后续步骤所需的列,从而减少内存占用并提高执行效率。这种分层处理方式使得当底层表结构变更时,只需修改对应的CTE定义,而无需改动复杂的窗口函数逻辑。
-- 示例:使用CTE预处理用户订单数据
WITH CleanOrders AS (
    SELECT
        user_id,
        order_date,
        amount,
        -- 预处理:统一货币单位,过滤无效订单
        CASE WHEN currency = 'USD' THEN amount ELSE amount * 7.0 END AS normalized_amount
    FROM raw_orders
    WHERE status = 'completed'
      AND amount > 0
)
SELECT
    user_id,
    order_date,
    normalized_amount,
    -- 在预处理后的数据上应用窗口函数
    SUM(normalized_amount) OVER (PARTITION BY user_id ORDER BY order_date) AS cumulative_spend
FROM CleanOrders;
上述代码展示了如何将数据清洗放在`CleanOrders` CTE中。主查询直接引用该CTE,并使用`SUM() OVER (...)`计算累计消费额。这种写法比直接在主查询中写长串`CASE WHEN`和`JOIN`要清晰得多。预期结果是生成一个包含用户ID、日期、标准化金额及累计金额的表格,每一行代表一次订单的累计状态。
如何在CTE基础上实现多层级窗口分析
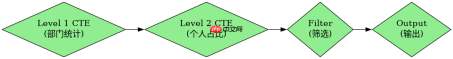
在CTE基础上实现多层级窗口分析的做法是:利用前一个CTE的输出作为下一个CTE的输入,或者在主查询中基于CTE的结果再次应用不同的窗口函数。具体而言,可以在一个CTE中计算全局排名,然后在另一个CTE或主查询中基于该排名进一步计算分位数或移动平均。这样做的好处是,每一层窗口函数的作用域被明确限定,避免了在一个巨大的`SELECT`语句中混合多种聚合逻辑导致的混乱。例如,先通过CTE计算出每个部门的总销售额,再在主查询中计算个人销售额占部门总额的比例,逻辑层次分明。

-- 示例:多层级窗口分析 - 计算个人绩效占比
WITH DepartmentStats AS (
    SELECT
        employee_id,
        department_id,
        sales_amount,
        -- 第一层窗口:计算部门总销售额
        SUM(sales_amount) OVER (PARTITION BY department_id) AS dept_total_sales
    FROM sales_records
),
PerformanceCalc AS (
    SELECT
        employee_id,
        department_id,
        sales_amount,
        dept_total_sales,
        -- 第二层窗口:计算个人占比
        ROUND(sales_amount * 100.0 / NULLIF(dept_total_sales, 0), 2) AS performance_pct
    FROM DepartmentStats
)
SELECT
    employee_id,
    department_id,
    performance_pct
FROM PerformanceCalc
WHERE performance_pct > 50;
这段代码首先通过`DepartmentStats` CTE计算每个部门的总销售额,然后在`PerformanceCalc` CTE中基于此计算个人的绩效百分比。最后在主查询中筛选出高绩效员工。这种链式CTE结构清晰地展示了数据从原始记录到最终指标的转变过程。预期输出是一个包含员工ID、部门ID及其绩效百分比的列表,仅显示占比超过50%的记录。这种方法特别适用于需要多维度统计的场景,如电商平台的用户复购率分析或金融领域的风险评分模型。
如何处理CTE中窗口函数的分区边界条件
在处理CTE中窗口函数的分区边界条件时,关键在于正确设置`PARTITION BY`和`ORDER BY`子句,特别是处理并列排名(Ties)和数据缺失的情况。具体做法是使用`DENSE_RANK()`而非`ROW_NUMBER()`来处理需要保留所有并列项的场景,或使用`COALESCE()`处理可能出现的NULL值。例如,在计算“每个类别中销量最高的前三商品”时,如果直接使用`ROW_NUMBER()`可能会因为并列情况导致漏选商品,而`DENSE_RANK()`能确保所有并列第一的商品都被选中。此外,若某些分区内没有数据,窗口函数默认返回NULL,需根据业务需求决定是保留还是剔除这些记录。
-- 示例:处理并列排名的边界条件
WITH RankedProducts AS (
    SELECT
        category_id,
        product_id,
        sales_volume,
        -- 使用DENSE_RANK处理并列,确保不遗漏同级别商品
        DENSE_RANK() OVER (PARTITION BY category_id ORDER BY sales_volume DESC) as rank_num
    FROM products
)
SELECT
    category_id,
    product_id,
    sales_volume,
    rank_num
FROM RankedProducts
WHERE rank_num
<p>该代码演示了如何使用`DENSE_RANK()`来正确处理并列排名。在`RankedProducts` CTE中,每个类别内的商品按销量降序排列,并列销量获得相同排名。主查询筛选出排名前三的商品,并通过`IS NOT NULL`确保不包含无效数据。预期结果是每个类别中销量最高且无并列冲突的商品列表,若存在并列,则所有并列商品均被包含。这种处理方式在报表生成和排行榜应用中非常常见,能有效避免因数据波动导致的排名不稳定问题。</p>


