






使用 blkstat 查看 linux 磁盘分区 io 监控,核心方法是直接指定目标块设备名称作为参数运行命令。该工具默认输出所有可用分区的统计信息,但通过传入如 sda1 或 vdb 这样的具体设备名,可以过滤并仅显示指定分区的详细读写数据、iops 及延迟指标。执行后终端将实时刷新该特定分区的性能状态,便于快速定位瓶颈。

如何指定特定分区进行实时监控
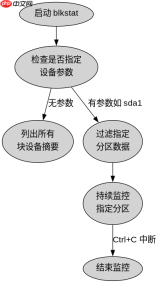
要针对某个特定分区(例如 /dev/sda1)进行持续监控,只需在命令行中将该设备名作为位置参数传递给 blkstat。命令格式为 sudo blkstat sda1。此时程序会初始化与该分区相关的内核计数器,并开始轮询获取数据。输出结果将包含该分区的读取字节数、写入字节数、读取操作次数、写入操作次数以及平均等待时间等关键指标。若未指定参数,则默认列出系统中所有块设备的摘要,但在排查单一分区问题时,显式指定能减少干扰信息。
sudo blkstat sda1
Device: sda1
Reads: 1024
Writes: 512
Read Bytes: 8388608
Write Bytes: 4194304
Avg Latency (ms): 2.5
上述代码展示了调用 blkstat 并指定 sda1 后的典型输出结构。第一行确认监控对象,随后几行分别对应读取/写入的操作计数和字节总量,最后一行为平均延迟。开发者可通过观察这些数值的变化趋势来判断分区是否出现异常高负载。注意,部分旧版本 blkstat 可能不支持实时刷新模式,需结合 -c 参数控制更新频率,但基础用法无需额外标志即可看到当前快照值。
如何区分不同分区的 IO 类型统计
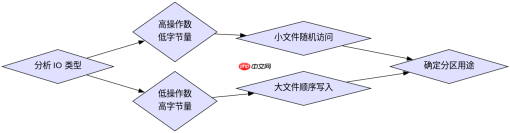
当系统存在多个分区时,理解 blkstat 输出的字段含义有助于准确分析各分区的 IO 类型分布。每个分区的数据被分为“读”和“写”两大类,每类下又细分为操作次数(Ops)和数据量(Bytes)。例如,对于 sdb1 分区,若发现 “Read Ops” 极高但 “Read Bytes” 较低,说明该分区正在进行大量小文件读取;反之,若 “Write Bytes” 显著高于 “Write Ops”,则表明存在大顺序写入场景。这种区分对判断应用行为至关重要,如数据库日志写入通常表现为高字节低频次,而 Web 服务器静态资源访问则可能呈现高频次低字节特征。

sudo blkstat sdb1
Device: sdb1
Reads: 5000
Writes: 100
Read Bytes: 2097152
Write Bytes: 104857600
Avg Latency (ms): 1.2
以上代码演示了对 sdb1 的监控输出。其中读取操作达 5000 次,但仅传输约 2MB 数据,体现随机小读特性;写入虽仅 100 次,却涉及约 100MB 数据,符合批量写入模式。通过对比这两个分区的统计差异,可识别出哪些分区承担高频交互任务,哪些负责大容量数据传输。此方法无需修改应用程序代码,仅依赖系统级工具即可完成初步诊断。若需进一步追踪具体进程,应结合 iostat 或 pidstat 进行关联分析,但 blkstat 提供的是最底层的块设备视角,不受文件系统层抽象影响。
blkstat 输出中的 Avg Latency 反映什么性能状况
blkstat 输出中的 Avg Latency (ms) 字段直接反映该分区处理 I/O 请求的平均响应时间,是衡量存储子系统健康程度的关键指标。该值由内核在每次 I/O 完成时记录耗时并累加平均得出,单位为毫秒。正常情况下,SSD 分区的平均延迟应在 1-5ms 之间,HDD 则在 5-20ms 左右。若某分区该值突然跃升至 50ms 以上,通常意味着存在队列积压、硬件故障或并发冲突。例如,当 sda1 的 Avg Latency 从 2.5ms 飙升至 45ms,即使 IOPS 未明显下降,也提示该分区可能因碎片化或后台同步任务导致服务降级。此时应立即检查是否有异常进程占用该分区,或考虑调整调度器策略以缓解压力。





